เครื่องมือ OCR และแก้ไขข้อความ PDF สแกนออนไลน์
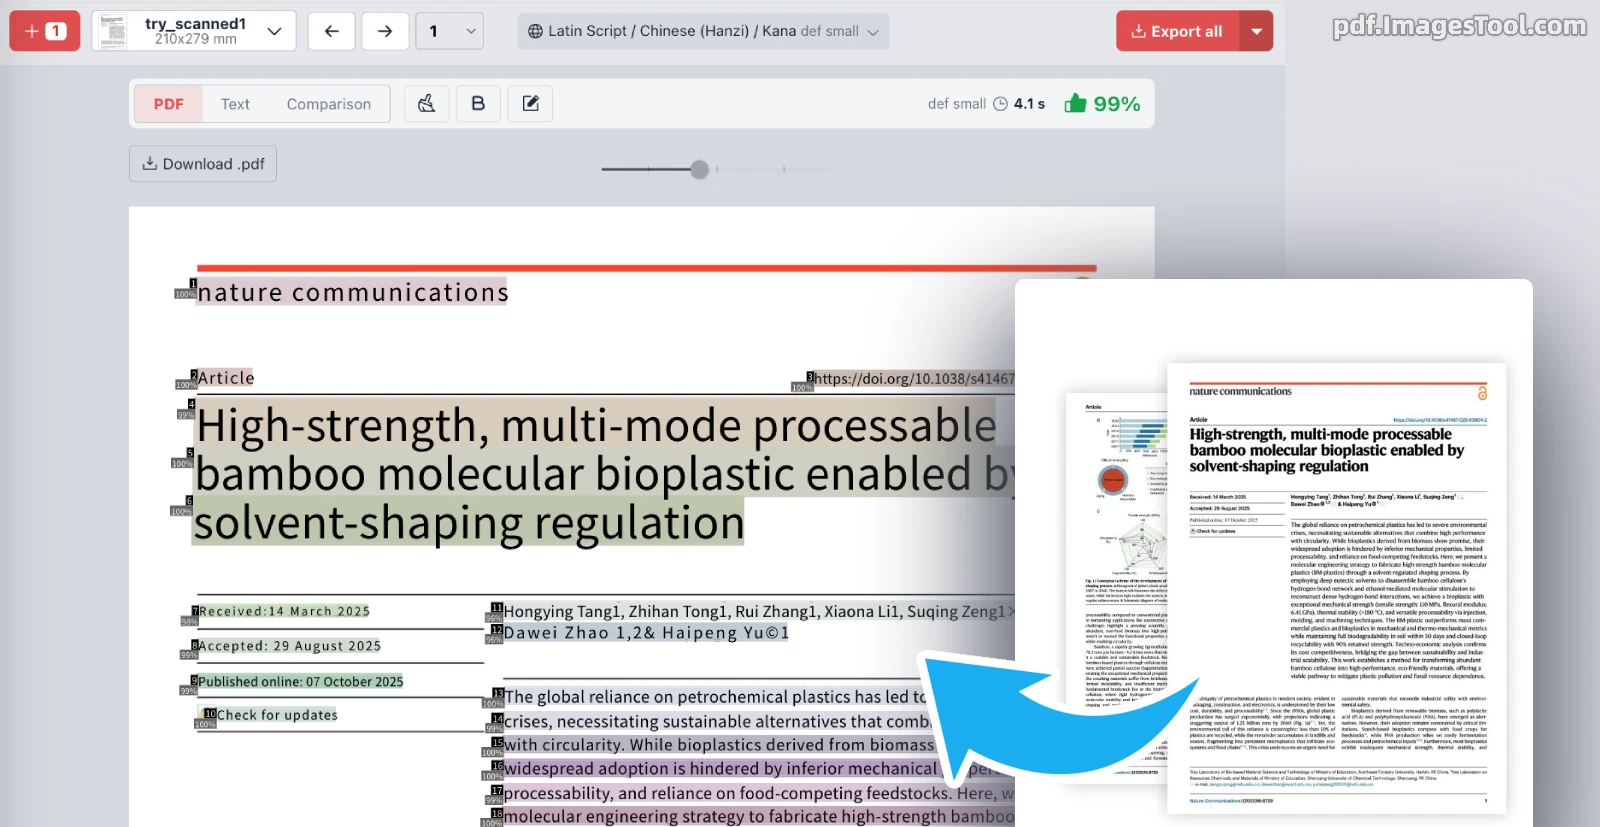
เครื่องมือ OCR สำหรับแปลงไฟล์ PDF ออนไลน์ที่มีประสิทธิภาพและความปลอดภัยสูง ออกแบบมาเป็นพิเศษสำหรับเอกสาร PDF สแกนและไฟล์รูปภาพ ทำการแปลงข้อความและจัดโครงสร้างหน้าเอกสารได้โดยตรงในเบราว์เซอร์ พร้อมฟังก์ชันแก้ไขข้อความแบบเรียลไทม์ และส่งออกเป็น PDF สองชั้นที่ค้นหาได้, ไฟล์ TXT หรือภาพเปรียบเทียบผลลัพธ์ได้ในคลิกเดียว
ขั้นตอนการใช้งาน
- อัปโหลดหน้า PDF ที่สแกนหรือไฟล์ภาพ (jpg, webp, png)
- เลือกภาษาหลักของเอกสารและโหมดความแม่นยำ (เร็ว / สมดุล / ความแม่นยำสูง)
- ระบบจะตรวจจับข้อความและคงลำดับการอ่านของคอลัมน์ให้อย่างถูกต้องโดยอัตโนมัติ
- ตรวจสอบผลลัพธ์ในตัวแก้ไขเพื่อแก้ไข ลบ หรือทำตัวหนาตามต้องการ
- คลิกปุ่มส่งออกเพื่อดาวน์โหลด PDF สองชั้นพร้อมเลเยอร์ข้อความโปร่งใส, ไฟล์ TXT หรือภาพเปรียบเทียบ
คุณสมบัติเด่นและจุดเด่น
- แก้ไขและตรวจทานข้อความออนไลน์ได้ทันที:หลังจากประมวลผล OCR คุณสามารถแก้ไข ปรับปรุง หรือทำข้อความตัวหนาได้ทันทีบนหน้าเว็บ ช่วยประหยัดเวลาในการตรวจทาน
- วิเคราะห์โครงสร้างหน้าเอกสารหลายคอลัมน์อัจฉริยะ:เหมาะสำหรับเอกสารวิชาการ หนังสือพิมพ์ และนิตยสาร โดยแยกแยะและเรียงลำดับเนื้อหาตามการอ่านจริงโดยไม่ปะปนข้ามคอลัมน์
- ส่งออก PDF สองชั้นที่ค้นหาข้อความได้:สร้างเอกสาร PDF ที่ซ้อนทับด้วยเลเยอร์ข้อความโปร่งใสที่ตรงกับภาพสแกนดั้งเดิมอย่างสมบูรณ์แบบ รักษาภาพลักษณ์เดิมไว้ 100% พร้อมให้คุณคัดลอกและค้นหาข้อความได้
- ตัวเลือกการส่งออกที่หลากหลาย:นอกจากไฟล์ PDF สองชั้นแล้ว ยังรองรับการดาวน์โหลดข้อความธรรมดา (TXT) และภาพเปรียบเทียบ (Comparison) เพื่อตรวจเช็กความแม่นยำ
- ทำงานบนเบราว์เซอร์อย่างปลอดภัยและเป็นส่วนตัว:การประมวลผลทั้งหมดเกิดขึ้นบนอุปกรณ์ของคุณ ไม่มีการอัปโหลดเอกสารสำคัญไปยังเซิร์ฟเวอร์ภายนอก รองรับการทำ OCR หลายหน้าพร้อมกัน
- ปรับเปลี่ยนระดับความแม่นยำได้ 3 ระดับ:สลับใช้งานระหว่างโหมด 'เร็ว (Fast)', 'สมดุล (Balanced)' และ 'ความแม่นยำสูง (High precision)' ได้ตามความต้องการของคุณ
รองรับภาษาและระบบตัวอักษรที่หลากหลายทั่วโลก
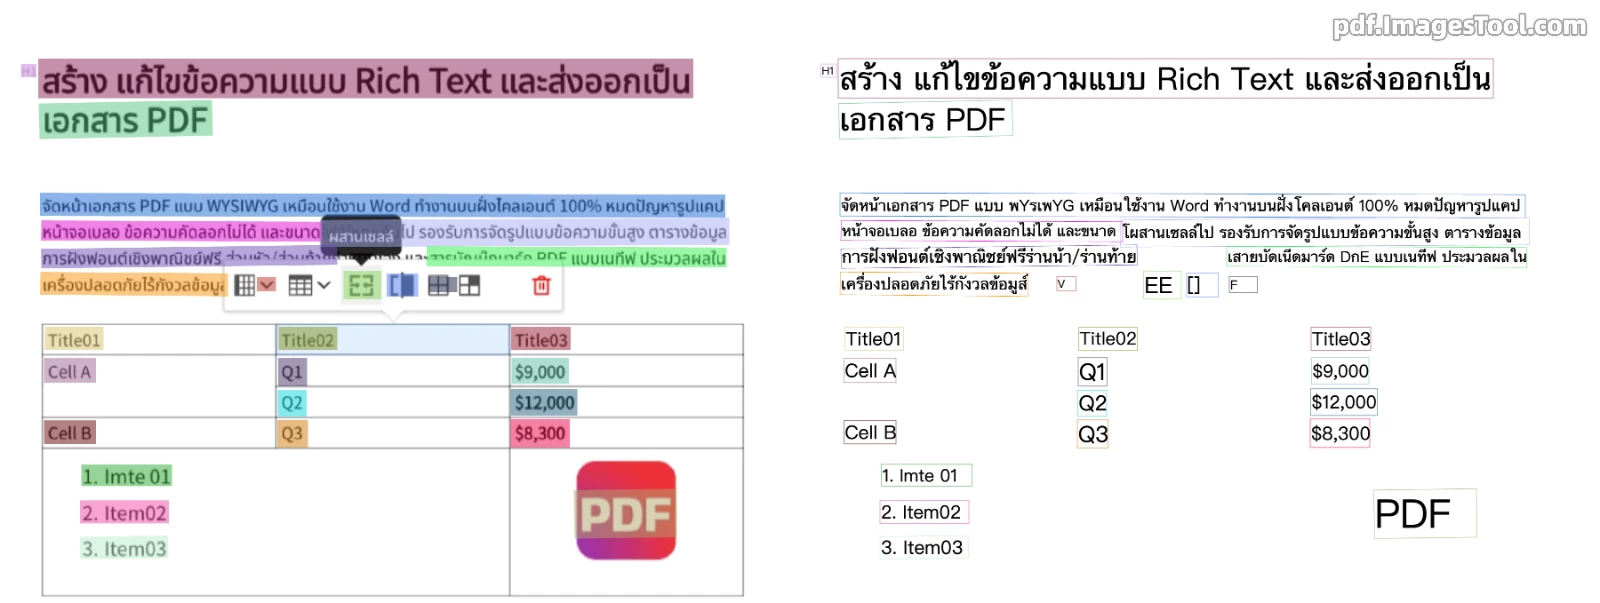
ตัวเลือกทุกภาษารองรับตัวอักษรละติน ตัวเลขอารบิก และเครื่องหมายวรรคตอนทั่วไปโดยอัตโนมัติ ครอบคลุมกว่า 100 ภาษาทั่วโลก:
อักษรไทยและระบบภาษาอื่นๆ
- ภาษาไทย (Thai)
- 한국어 (ภาษาเกาหลี)
- Ελληνικά (ภาษากรีก)
- தமிழ் (ภาษาทมิฬ)
- తెలుగు (ภาษาเตลูกู)
อักษรฮั่น คะนะ และอักษรละติน (มากกว่า 50 ภาษา)
English, 简体中文, 繁體中文, 日本語, Tiếng Việt, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Español, Français, Deutsch, Italiano, Português, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, Azərbaycan dili, Oʻzbekcha, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori เป็นต้น
อักษรซีริลลิก (33 ภาษา)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
อักษรอาหรับ (8 ภาษา)
العربية (ภาษาอาหรับ), فارسی (ภาษาเปอร์เซีย), ئۇيغۇرچە (ภาษาอุยกูร์), اردو (ภาษาอูรดู), پښتو (ภาษาพาชโต), کوردی (ภาษาเคิร์ด), سنڌي (ภาษาซินธี), بلۆچی (ภาษาบาโลจี)
อักษรเทวนาครี (12 ภาษา)
हिन्दी (ภาษาฮินดี), मराठी (ภาษามราฐี), नेपाली (ภาษาเนปาล), संस्कृतम् (ภาษาสันสกฤต), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी
คำถามที่พบบ่อย (FAQ)
- PDF สองชั้นพร้อมเลเยอร์ข้อความโปร่งใสคืออะไร?
- คือไฟล์ PDF ที่วางเลเยอร์ข้อความโปร่งใสที่มองไม่เห็นแต่ตรวจจับได้ซ้อนทับบนภาพสแกนอย่างแม่นยำ ช่วยคงรูปแบบหน้ากระดาษเดิมไว้ 100% ในขณะที่เปิดให้ผู้ใช้สามารถเลือก คัดลอก และค้นหาข้อความได้
- เอกสารที่เป็นความลับจะถูกอัปโหลดขึ้นคลาวด์หรือไม่?
- ไม่มีการอัปโหลด การประมวลผลทั้งหมดทำงานภายในเบราว์เซอร์ผ่านระบบประมวลผลบนเครื่องของคุณ เอกสารจะไม่ถูกส่งออกไปภายนอก มั่นใจได้ในความปลอดภัยสำหรับสัญญาและเอกสารทางการเงิน
- ระบบรองรับเอกสารที่มีตัวเลขและตัวอักษรภาษาอังกฤษผสมกันหรือไม่?
- รองรับอย่างเต็มที่ ทุกตัวเลือกภาษาถูกตั้งค่าให้อ่านตัวอักษรภาษาอังกฤษ ตัวเลข และเครื่องหมายวรรคตอนพื้นฐานได้โดยอัตโนมัติ
หมายเหตุ: เครื่องมือ OCR นี้ขับเคลื่อนด้วยโมเดล Deep Learning PP-OCRv5 และ PP-OCRv6 ให้ความแม่นยำสูงแม้ในเอกสารที่มีโครงสร้างซับซ้อน