線上掃描型 PDF OCR 文字辨識與編輯工具
高效、安全的線上 PDF OCR 辨識工具,專為掃描件 PDF、圖片型檔案設計。直接喺瀏覽器內完成檔案辨識與排版還原,支援線上即時編輯與校對,並可一鍵匯出雙層可搜尋 PDF、TXT 文件同埋圖文對比結果。
使用流程
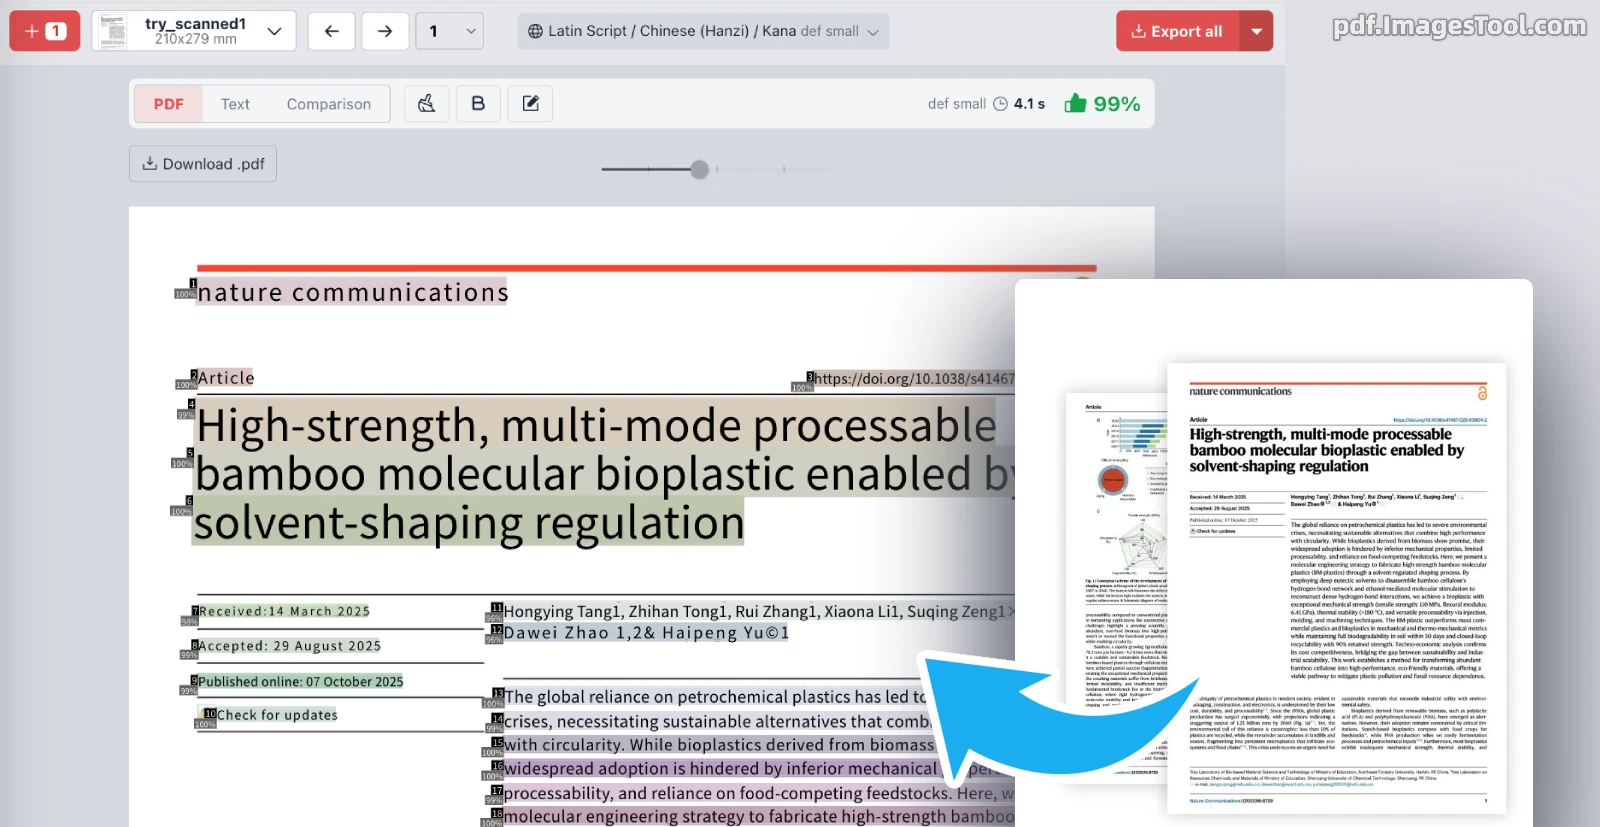
- 上載掃描型 PDF 頁面或圖片(jpg、webp、png)。
- 選擇檔案主要文字語言同埋辨識精度模式(快速 / 平衡 / 高精度)。
- 系統自動辨識文字區域並維持正確嘅分欄順序。
- 喺內置編輯器入面檢視辨識結果,可按需要修改、刪除文字或設定粗體。
- 點擊匯出按鈕,按需要下載雙層透明文字 PDF、純 TXT 或比對圖。
核心功能與特色
- 線上即時編輯與校對:OCR 辨識完成後,可直接喺頁面中修改、刪除文字或設定粗體,所見即所得,顯著提升校對效率。
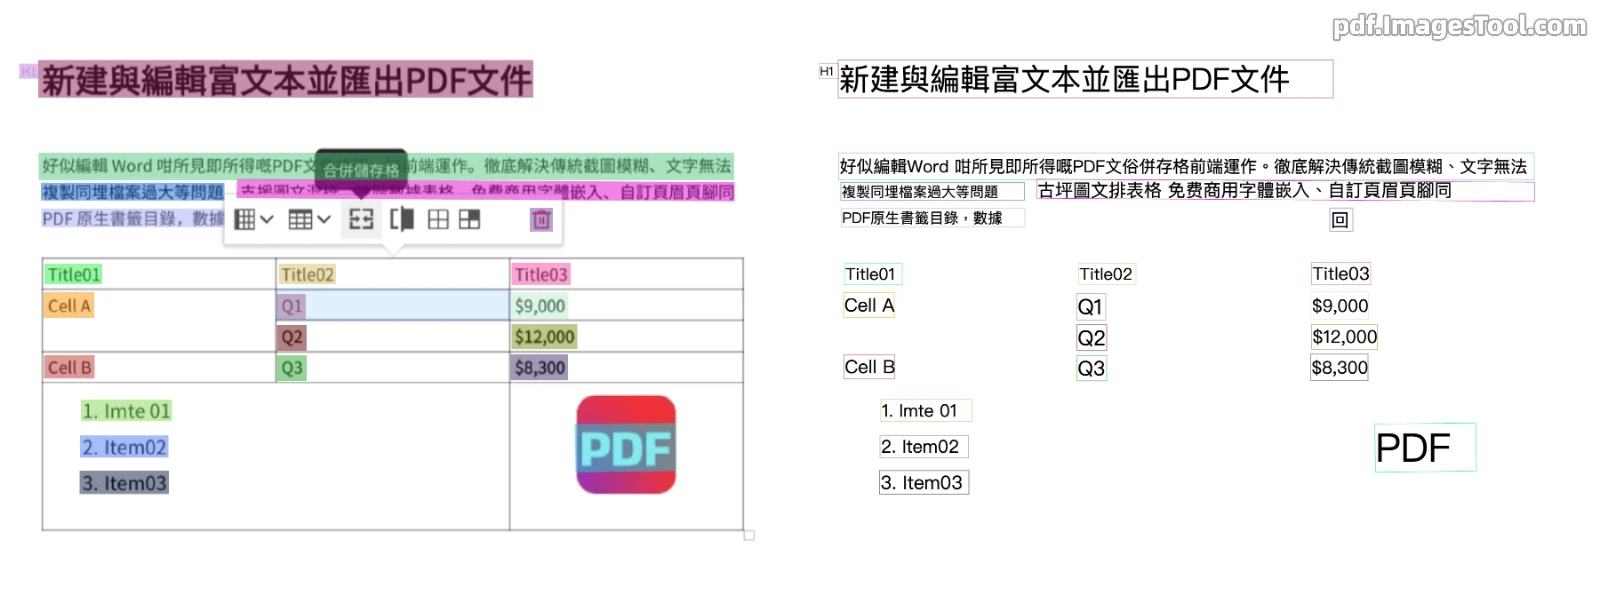
- 智能多欄排版與閱讀順序還原:針對學術論文、期刊報紙等多欄排版,自動分析版面配置,準確跟隨閱讀邏輯提取文字,防止跨欄串行。
- 支援匯出可搜尋雙層 PDF:一鍵生成疊加透明文字層嘅雙層 PDF 檔案,完美保留原圖排版與視覺細節,同時支援文字複製與全篇搜尋。
- 多樣化匯出選項:除雙層 PDF 外,亦支援單獨匯出純文字檔(TXT)以及辨識比對圖(Comparison),方便即時比對辨識精度。
- 純瀏覽器端運作,保障私隱:檔案處理全程喺本地瀏覽器端運算完成,無需擔心機密檔案外洩,同時支援多頁面與批次 OCR 處理。
- 多檔模型精度靈活切換:提供'快速(Fast)'、'平衡(Balanced)'同'高精度(High precision)'三種檔位,滿足速度優先或極致精準度需求。
廣泛的多語言與跨文字辨識支援
每種語言選項均預設支援英文字母、數字同埋常見標點符號辨識,涵蓋全球過百種主流同區域語言:
中文字、假名及拉丁字母(50+ 種語言)
繁體中文、簡體中文、日本語、English、Tiếng Việt、Bahasa Indonesia、Bahasa Melayu、Tagalog、Türkçe、Azərbaycan dili、Oʻzbekcha、Deutsch、Français、Italiano、Español、Português、Nederlands、Polski、Čeština、Slovenčina、Magyar、Română、Srpski (latinica)、Hrvatski、Bosanski、Slovenščina、Shqip、Svenska、Dansk、Norsk、Suomi、Eesti、Latviešu、Lietuvių、Íslenska、Gaeilge、Cymraeg、Euskara、Català、Galego、Occitan、Rumantsch、Lëtzebuergesch、Malti、Kurdî、Latina、Kiswahili、Afrikaans、Runasimi、Te Reo Māori 等。
西里爾字母 Script(33 種語言)
Русский、Беларуская、Українська、Српски (ћирилица)、Български、Монгол хэл、Аҧсшәа、Адыгэбзэ、Адыгэбзэ (Къэбэрдей)、Авар мацӀ、Дарган мез、Гӏалгӏай мотт、Нохчийн мотт、Лакку маз、Лезги чIал、Табасаран чIал、Қазақша、Кыргызча、Тоҷикӣ、Македонски、Татарча、Чӑвашла、Башҡортса、Марий йылме、Мокшень / Эрзянь кяль、Удмурт кыл、Коми кыв、Ирон æвзаг、Буряад хэлэн、Хальмг келн、Тыва дыл、Саха тыла、Qaraqalpaqsha (Кирилл)。
阿拉伯文 Script(8 種語言)
العربية(阿拉伯文)、فارسی(波斯文)、ئۇيغۇرچە(維吾爾文)、اردو(烏爾都文)、پښتو(普什圖文)、کوردی(庫爾德文)、سنڌي(信德文)、بلۆچی(俾路支文)。
天城文 Script(12 種語言)
हिन्दी(印地文)、मराठी(馬拉地文)、नेपाली(尼泊爾文)、संस्कृतम्(梵文)、मैथिली、भोजपुरी、मगही、सादरी、नेपाल भाषा、कोंकणी、हरियाणवी、बिहारी。
其他語系
- 한국어(韓文)
- ภาษาไทย(泰文)
- Ελληνικά(希臘文)
- தமிழ்(泰米爾文)
- తెలుగు(泰盧固文)
常見問題解答 (FAQ)
- 咩係帶有透明文字層嘅雙層 PDF?
- 雙層 PDF 會喺掃描圖片下方或上方嵌入一層對齊嘅透明文字。咁樣既可 100% 保持原始掃描影像嘅細節外觀,又可以令檔案支援文字複製、螢光標記同埋全文檢索。
- 我嘅機密掃描文件會唔會被上傳到雲端?
- 唔會。本工具完全喺瀏覽器本地引擎完成運算,所有文字分析同檔案匯出都唔會離開你部裝置,非常適合合約、病歷、財務單據等高私隱檔案。
- 係咪支援包含英文同數字嘅混合檔案?
- 支援。所有辨識選項均已內置英文字母、數字同常用標點符號嘅辨識能力,無需額外手動切換。
註:本工具 OCR 引擎採用 PP-OCRv5 與 PP-OCRv6 深度學習模型構建,提供更卓越嘅複雜排版解析同文字辨識準確率。