Ferramenta online de OCR e edição de texto para PDFs digitalizados
Ferramenta de OCR em PDF online, rápida e segura, desenvolvida sob medida para documentos digitalizados e imagens. Realize o reconhecimento de texto e a recuperação de diagramação diretamente no navegador, com edição em tempo real e exportação para PDF pesquisável de duas camadas, arquivos TXT e comparações visuais.
Como Usar
- Envie páginas de PDF digitalizado ou arquivos de imagem (jpg, webp, png).
- Selecione o idioma predominante e o modo de precisão do OCR (Rápido / Equilibrado / Alta precisão).
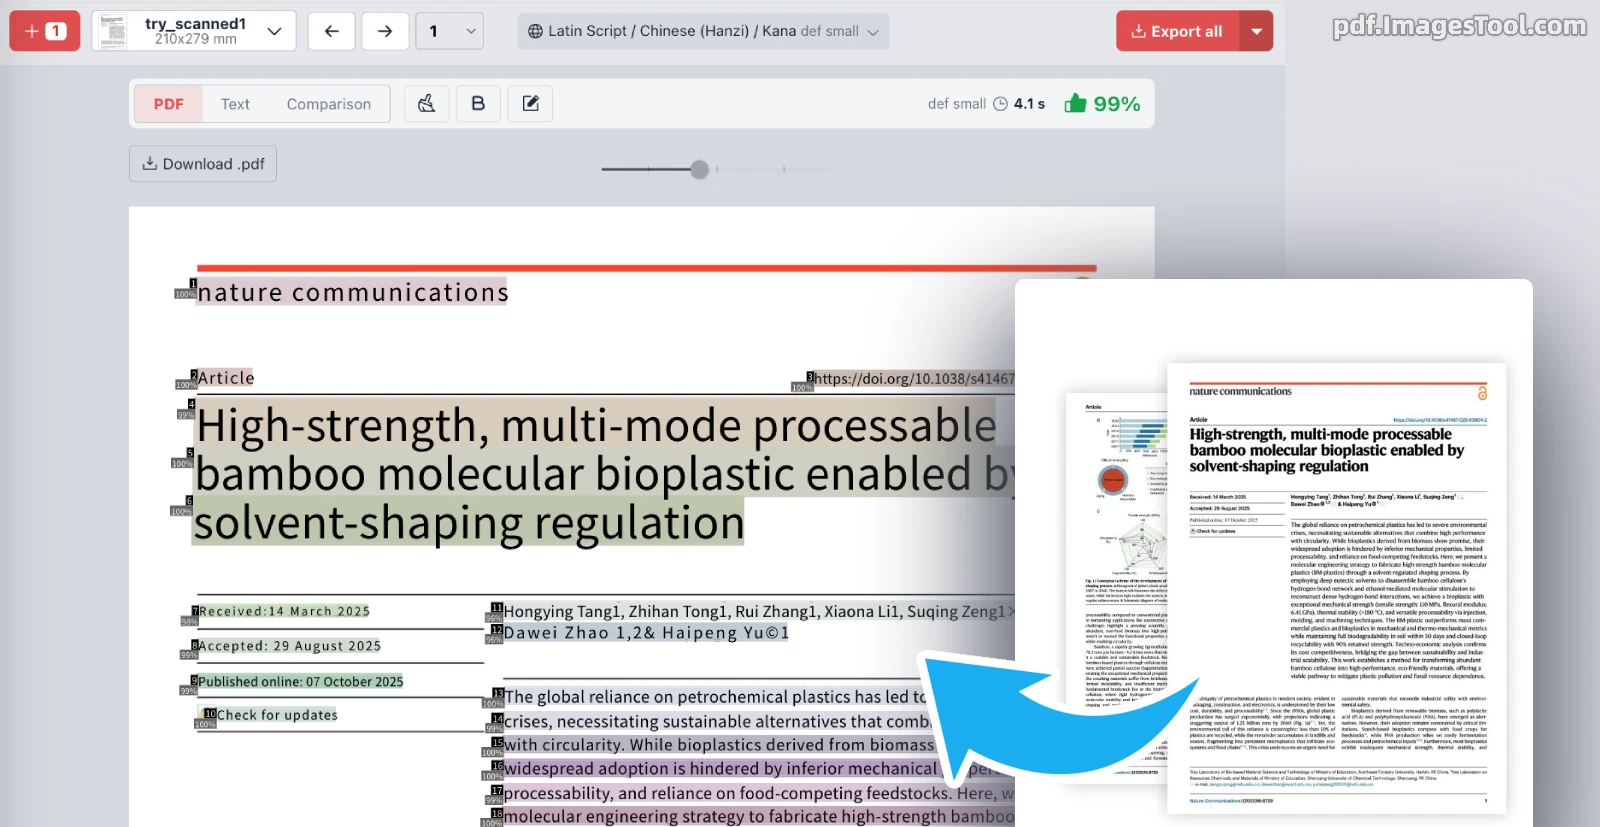
- O sistema detecta blocos de texto mantendo a ordem correta de colunas.
- No editor integrado, confira o resultado e edite, remova ou aplique negrito ao texto conforme necessário.
- Clique em Exportar para baixar o PDF de camada dupla com texto transparente, arquivo TXT ou imagem de comparação.
Principais Recursos e Diferenciais
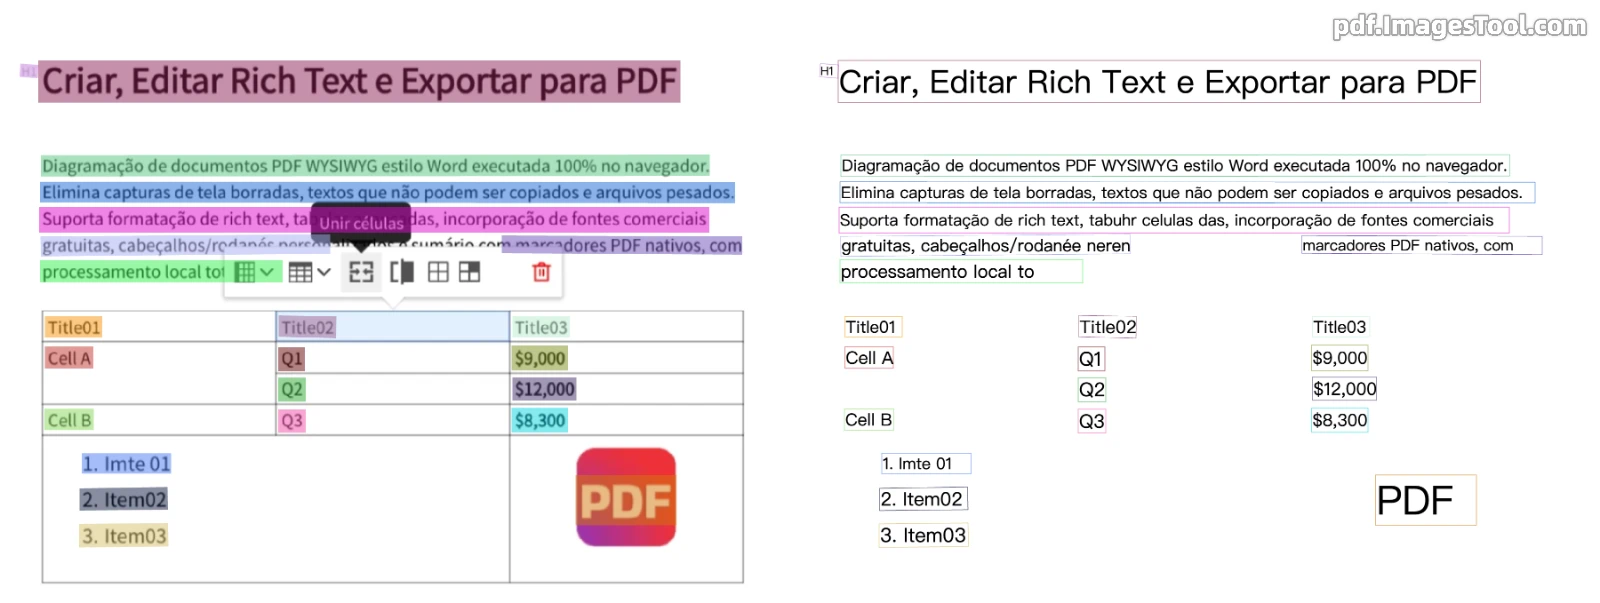
- Edição e revisão online em tempo real:Assim que o OCR é finalizado, você pode alterar, excluir e destacar o texto reconhecido no próprio navegador sem softwares adicionais.
- Análise inteligente de layouts multicolunas:Identifica a estrutura diagramada de periódicos científicos e jornais, extraindo o conteúdo de acordo com o fluxo natural de leitura sem cruzar colunas.
- Exportação em PDF pesquisável de dupla camada:Gera um PDF com camada de texto transparente alinhada à imagem original, mantendo a estética intacta e permitindo seleção, cópia e busca textual.
- Opções variadas de exportação:Exporte em PDF com texto embutido, em formato de texto puro (TXT) ou como imagem de comparação lado a lado para conferência de precisão.
- Execução local no navegador com privacidade absoluta:Todo o processamento ocorre no próprio navegador do usuário sem envio de arquivos para a nuvem, ideal para contratos e dados confidenciais.
- Três níveis flexíveis de precisão:Alterne entre 'Rápido (Fast)', 'Equilibrado (Balanced)' e 'Alta precisão (High precision)' de acordo com suas necessidades operacionais.
Suporte amplo a múltiplos idiomas e alfabetos
Cada idioma conta com suporte padrão para caracteres do alfabeto latino, numerais arábicos e pontuação usual, cobrindo mais de 100 idiomas:
Alfabeto latino, hanzi e kana (mais de 50 idiomas)
Português, English, Español, Français, Deutsch, Italiano, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, 简体中文, 繁體中文, 日本語, Tiếng Việt, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Azərbaycan dili, Oʻzbekcha, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori, etc.
Alfabeto cirílico (33 idiomas)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
Alfabeto árabe (8 idiomas)
العربية (Árabe), فارسی (Persa), ئۇيغۇرچە (Uigur), اردو (Urdu), پښتو (Pashto), کوردی (Curdo), سنڌي (Sindi), بلۆچی (Balúchi).
Escrita devanágari (12 idiomas)
हिन्दी (Hindi), मराठी (Marati), नेपाली (Nepali), संस्कृतम् (Sânscrito), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी.
Outros alfabetos
- 한국어 (Coreano)
- ภาษาไทย (Tailandês)
- Ελληνικά (Grego)
- தமிழ் (Tâmil)
- తెలుగు (Telugu)
Perguntas Frequentes (FAQ)
- O que é um PDF de camada dupla com texto transparente?
- É um arquivo PDF que sobrepõe uma camada de texto invisível e indexável exatamente sobre a imagem escaneada. Dessa forma, preserva-se o visual autêntico do original, permitindo selecionar, copiar e pesquisar termos no documento.
- Meus arquivos sigilosos são enviados para servidores externos?
- Não. A computação é feita inteiramente dentro do navegador por meio de mecanismos locais. Seus arquivos não saem do seu computador, garantindo sigilo para contratos, exames médicos e balanços contábeis.
- O sistema reconhece documentos com números e letras misturados?
- Sim, o reconhecimento de letras latinas, pontuação padrão e algarismos numéricos permanece ativo por padrão em todas as línguas.
Observação: O mecanismo de OCR utiliza as redes neurais profundas PP-OCRv5 e PP-OCRv6, garantindo altíssima acurácia de leitura mesmo em layouts complexos.