Herramienta online de OCR y edición de texto para PDF escaneados
Herramienta OCR online, potente y segura, diseñada especialmente para documentos escaneados en PDF e imágenes. Realice el reconocimiento óptico de caracteres y la reconstrucción de la maquetación en su navegador, con edición en tiempo real y exportación en PDF de doble capa con texto transparente, TXT e imágenes comparativas.
Pasos de uso
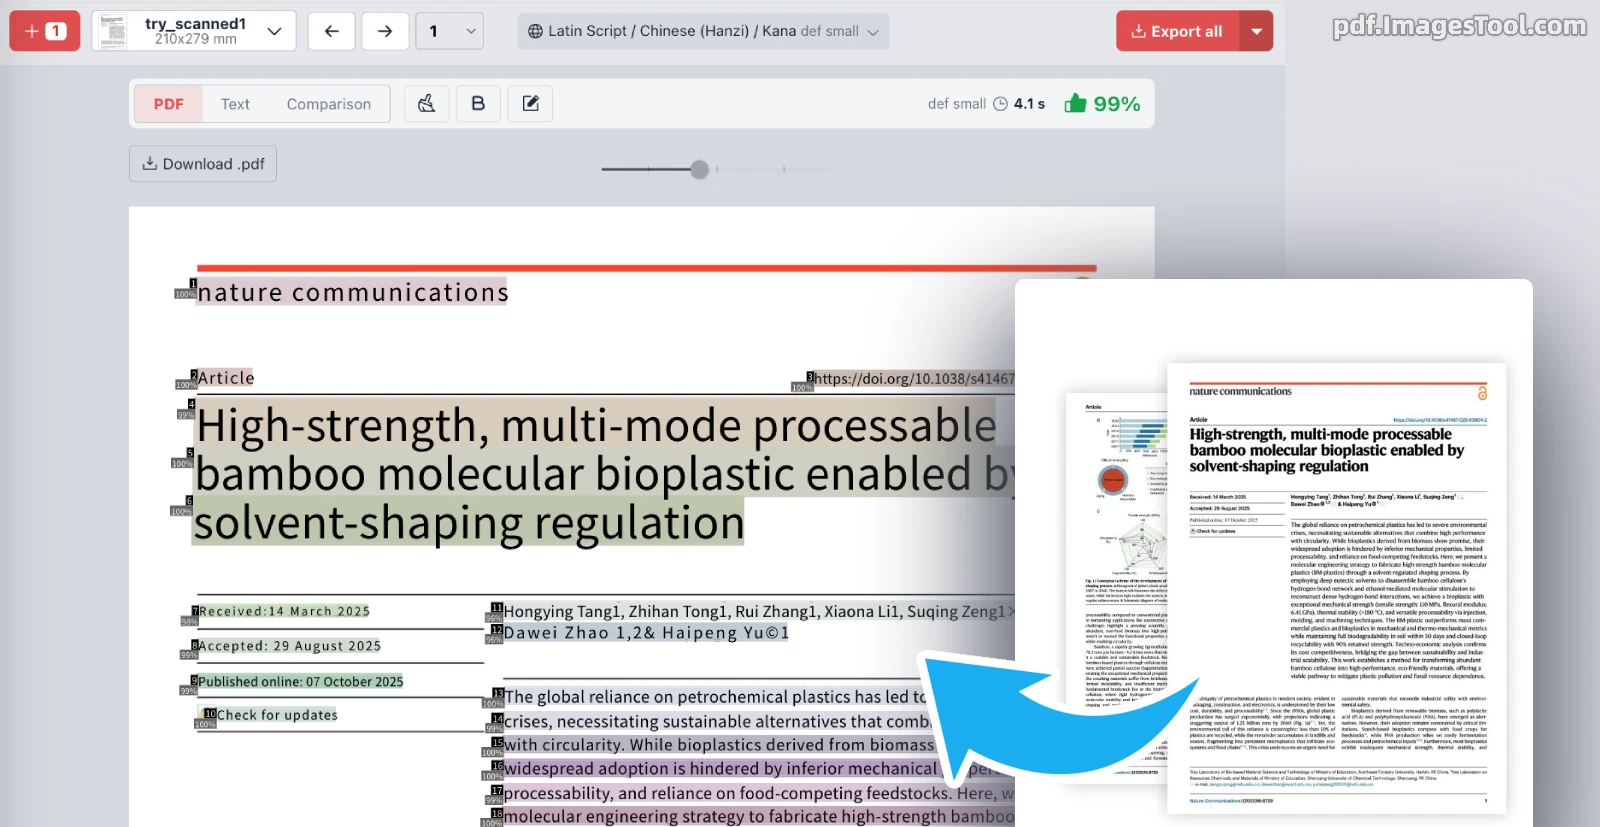
- Suba páginas de PDF escaneado o imágenes (jpg, webp, png).
- Seleccione el idioma del documento y el modo de precisión (Rápido / Equilibrado / Alta precisión).
- El sistema identifica automáticamente las áreas de texto respetando el orden de lectura en columnas.
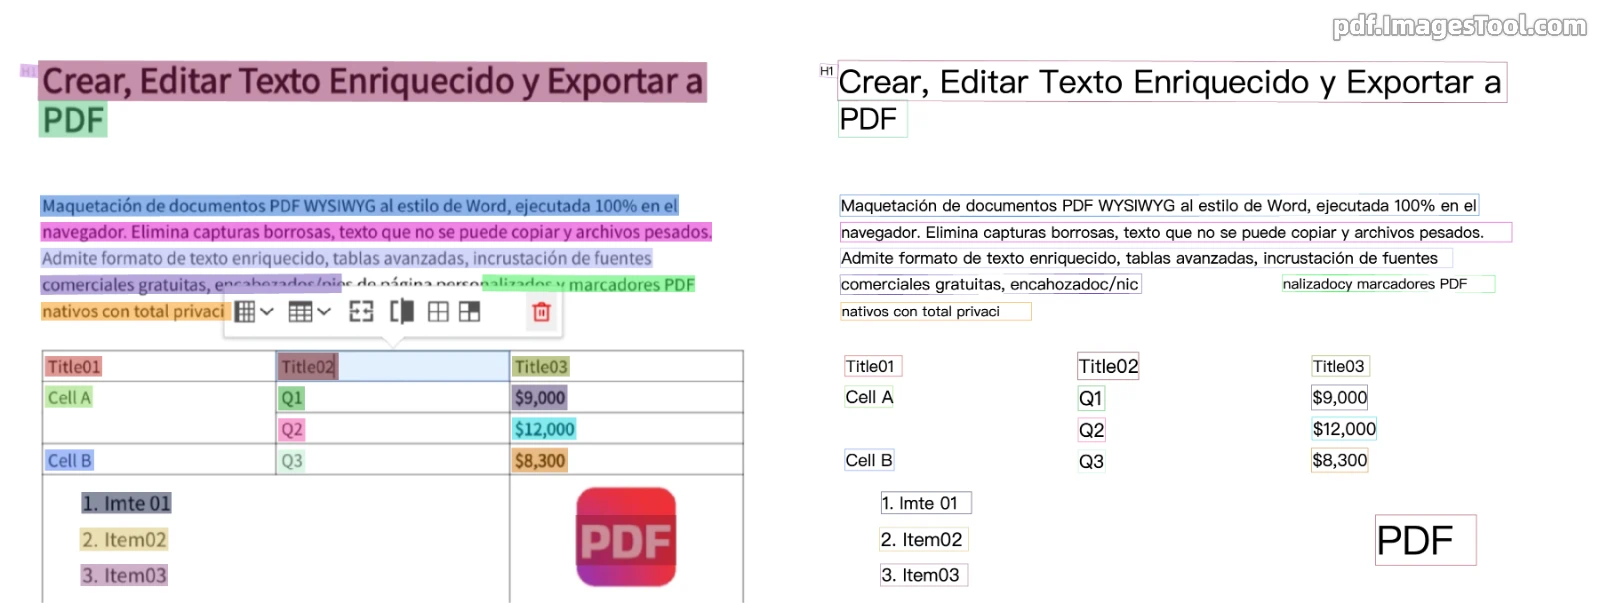
- Revise y edite el texto reconocido en el editor incorporado para corregir, borrar o poner en negrita.
- Haga clic en Exportar para descargar el PDF de doble capa con texto transparente, el archivo TXT o la imagen de comparación.
Funciones principales y ventajas
- Edición y corrección en tiempo real:Modifique, elimine o resalte texto reconocido directamente en la pantalla de su navegador con previsualización inmediata.
- Análisis inteligente de maquetaciones multicolumna:Detecta con precisión la disposición de periódicos y revistas científicas para extraer el texto siguiendo el orden de lectura humano sin mezclar columnas.
- Exportación a PDF editable y de doble capa:Crea un PDF que superpone una capa de texto transparente sobre la imagen original, permitiendo seleccionar, copiar y buscar texto sin perder la estética original.
- Múltiples formatos de exportación:Exporte el resultado en PDF con texto incrustado, como texto sin formato (TXT) o en imágenes de comparación visual directa.
- Procesamiento local en navegador con total privacidad:Los documentos se procesan en el entorno local de su navegador web sin enviarse a servidores externos, protegiendo archivos confidenciales y permitiendo OCR por lotes.
- Tres niveles de precisión ajustables:Alterne fácilmente entre 'Rápido (Fast)', 'Equilibrado (Balanced)' y 'Alta precisión (High precision)' según sus prioridades de tiempo o exactitud.
Compatibilidad integral con múltiples idiomas y alfabetos
Cada opción de idioma integra de manera nativa el reconocimiento de caracteres latinos, números arábigos y puntuación básica para más de 100 idiomas:
Alfabeto latino, hanzi y kana (más de 50 idiomas)
Español, English, Français, Deutsch, Italiano, Português, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, 简体中文, 繁體中文, 日本語, Tiếng Việt, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Azərbaycan dili, Oʻzbekcha, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori, etc.
Alfabeto cirílico (33 idiomas)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
Alfabeto árabe (8 idiomas)
العربية (Árabe), فارسی (Persa), ئۇيغۇرچە (Uigur), اردو (Urdu), پښتو (Pastún), کوردی (Kurdo), سنڌي (Sindhi), بلۆچی (Baluchi).
Escritura devanagari (12 idiomas)
हिन्दी (Hindi), मराठी (Maratí), नेपाली (Nepalí), संस्कृतम् (Sánscrito), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी.
Otros alfabetos
- 한국어 (Coreano)
- ภาษาไทย (Tailandés)
- Ελληνικά (Griego)
- தமிழ் (Tamil)
- తెలుగు (Telugu)
Preguntas frecuentes (FAQ)
- ¿Qué es un PDF de doble capa con texto transparente?
- Es un archivo PDF que inserta una capa de texto invisible alineada milimétricamente sobre la imagen escaneada. Esto preserva el aspecto visual original al 100 % al tiempo que hace posible seleccionar palabras, copiarlas y realizar búsquedas de texto completo.
- ¿Se suben mis archivos confidenciales a servidores externos?
- No. El motor OCR se ejecuta íntegramente de forma local en su navegador web. Los documentos no abandonan su dispositivo, garantizando máxima seguridad para contratos, informes clínicos y estados contables.
- ¿Es posible reconocer documentos que mezclan texto y números?
- Sí, el reconocimiento de letras latinas, dígitos y puntuación habitual está activado de manera predeterminada en todas las configuraciones.
Nota: El motor OCR está optimizado con modelos de aprendizaje profundo PP-OCRv5 y PP-OCRv6, brindando excelente capacidad para resolver maquetaciones complejas y máxima precisión.