ऑनलाइन स्कैन किया गया PDF OCR टेक्स्ट पहचान और संपादन टूल
स्कैन किए गए PDF और इमेज-आधारित दस्तावेजों के लिए तैयार किया गया सुरक्षित और शक्तिशाली ऑनलाइन PDF OCR टूल। सीधे अपने ब्राउज़र में टेक्स्ट पहचान और लेआउट रीस्टोरेशन करें, रीयल-टाइम में संपादन व प्रूफरीडिंग करें, और सर्च करने योग्य दोहरी परत वाले PDF, TXT फाइल और तुलनात्मक दृश्य निर्यात करें।
उपयोग करने की प्रक्रिया
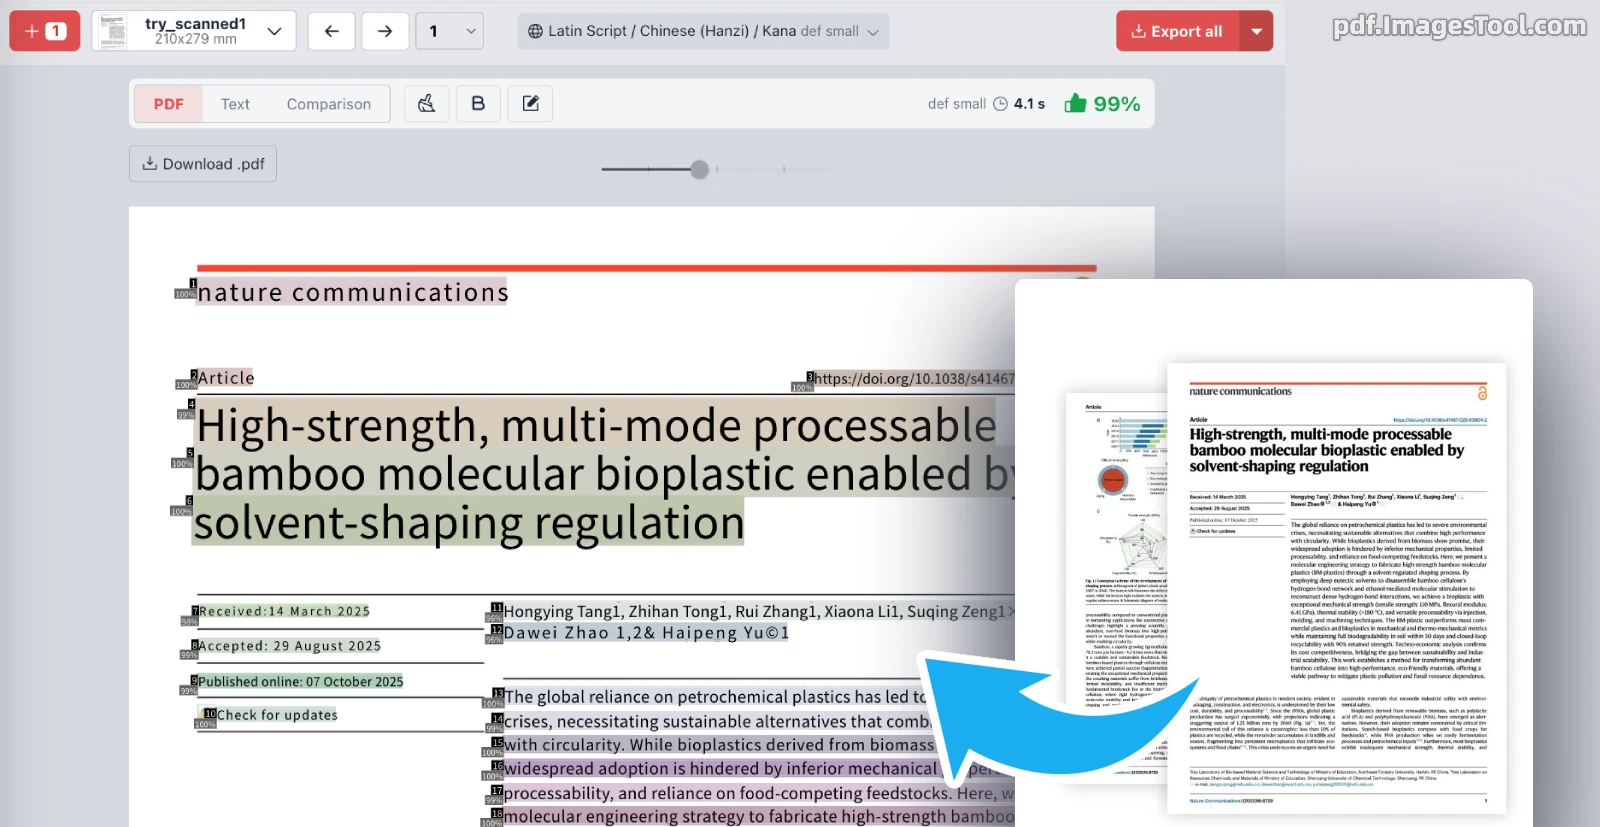
- स्कैन किए गए PDF पेज या इमेज फाइलें (jpg, webp, png) अपलोड करें।
- दस्तावेज़ की मुख्य भाषा और पहचान मोड (तेज़ / संतुलित / उच्च सटीकता) चुनें।
- सिस्टम टेक्स्ट ब्लॉक को पहचानकर कॉलम के पढ़ने के क्रम को बरकरार रखता है।
- इन-बिल्ट एडिटर में परिणाम देखें और टेक्स्ट को संशोधित, हटाएं या बोल्ड करें।
- सर्च करने योग्य पारदर्शी टेक्स्ट PDF, TXT या तुलनात्मक इमेज डाउनलोड करने के लिए निर्यात पर क्लिक करें।
मुख्य विशेषताएं और लाभ
- ऑनलाइन रीयल-टाइम संपादन और प्रूफरीडिंग:OCR के बाद सीधे ब्राउज़र में ही टेक्स्ट में सुधार करें, अनचाहे हिस्से हटाएं और फॉन्ट को हाइलाइट करें।
- मल्टी-कॉलम लेआउट विश्लेषण:अकादमिक शोध पत्रों, पत्रिकाओं और समाचार पत्रों के कॉलम लेआउट का विश्लेषण कर स्वाभाविक क्रम में टेक्स्ट निकालता है।
- सर्च करने योग्य 2-लेयर PDF निर्यात:मूल स्कैन इमेज पर पारदर्शी टेक्स्ट लेयर जोड़ता है, जिससे मूल डिज़ाइन अक्षुण्ण रहते हुए टेक्स्ट चयन, कॉपी और सर्च की सुविधा मिलती है।
- विविध निर्यात प्रारूप:सर्च करने योग्य PDF के अलावा प्लेन टेक्स्ट (TXT) और सटीकता जांच के लिए तुलनात्मक छवियां निर्यात करें।
- ब्राउज़र आधारित गोपनीयता और सुरक्षा:प्रोसेसिंग पूरी तरह से आपके ब्राउज़र में होती है। कोई भी गोपनीय दस्तावेज बाहरी सर्वर पर अपलोड नहीं होता है।
- तीन सटीकता स्तर:अपनी गति और परिशुद्धता की आवश्यकता के अनुसार 'तेज़ (Fast)', 'संतुलित (Balanced)' और 'उच्च सटीकता (High precision)' मोड चुनें।
बहुभाषी और बहु-लिपि समर्थन
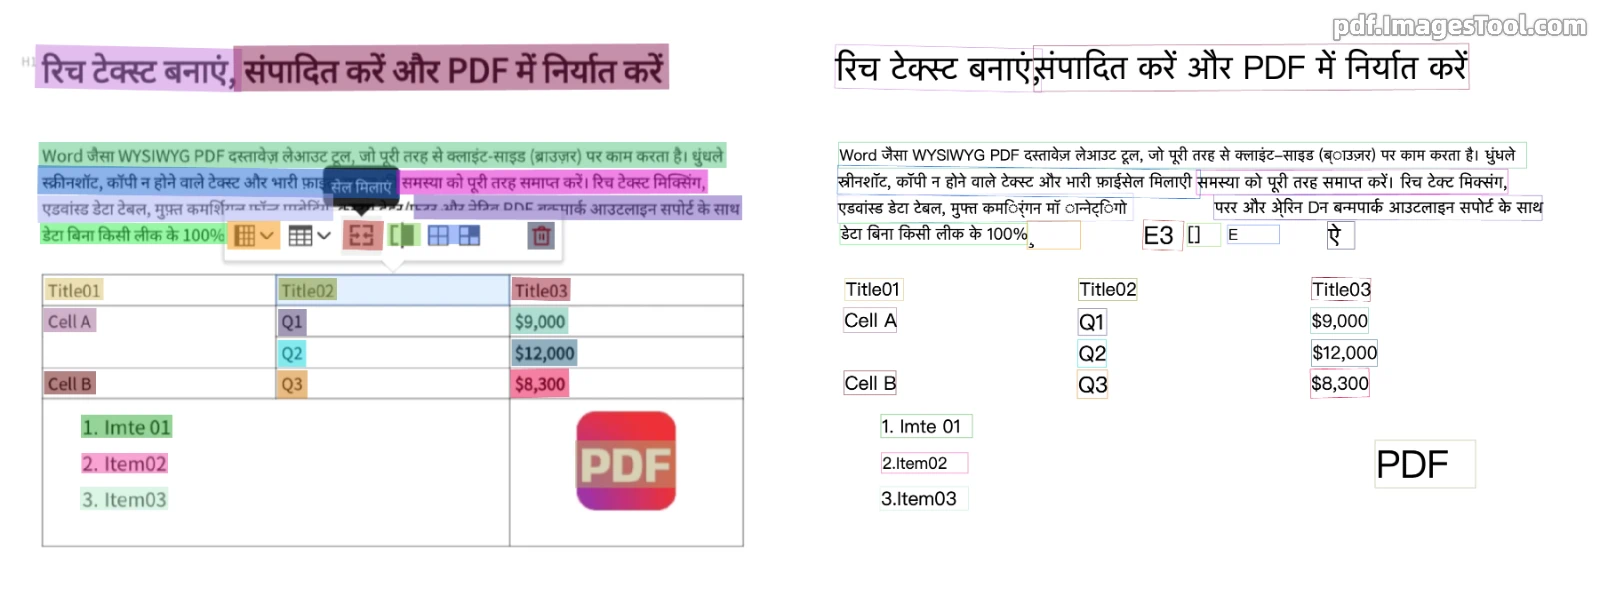
प्रत्येक भाषा विकल्प में अंग्रेजी अक्षर, अंक और सामान्य विराम चिह्नों की पहचान स्वाभाविक रूप से शामिल है, जो 100 से अधिक भाषाओं का समर्थन करती है:
देवनागरी लिपि (12 भाषाएं)
हिन्दी (Hindi), मराठी (Marathi), नेपाली (Nepali), संस्कृतम् (Sanskrit), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी आदि।
लैटिन, चीनी और काना लिपियाँ (50+ भाषाएँ)
English, 简体中文, 繁體中文, 日本語, Español, Français, Deutsch, Italiano, Português, Tiếng Việt, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Azərbaycan dili, Oʻzbekcha, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori आदि।
सिरिलिक लिपि (33 भाषाएँ)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
अरबी लिपि (8 भाषाएँ)
العربية (अरबी), فارسی (फ़ारसी), ئۇيغۇرچە (उइघुर), اردو (उर्दू), پښتو (पश्तो), کوردی (कुर्दिश), سنڌي (सिंधी), بلۆچی (बलूची).
अन्य लिपियाँ
- 한국어 (कोरियाई)
- ภาษาไทย (थाई)
- Ελληνικά (ग्रीक)
- தமிழ் (तमिल)
- తెలుగు (तेलुगु)
अक्सर पूछे जाने वाले प्रश्न (FAQ)
- पारदर्शी टेक्स्ट वाली 2-लेयर PDF क्या होती है?
- यह एक ऐसा PDF दस्तावेज़ है जिसमें स्कैन की गई छवि के ऊपर एक अदृश्य टेक्स्ट परत जोड़ी जाती है। यह मूल दस्तावेज़ के रूप को बनाए रखते हुए टेक्स्ट को चुनने, कॉपी करने और खोजने योग्य बनाती है।
- क्या मेरे गोपनीय दस्तावेज़ क्लाउड पर अपलोड किए जाते हैं?
- नहीं। सभी गणनाएं आपके स्थानीय ब्राउज़र वातावरण में होती हैं। कोई भी फाइल आपके कंप्यूटर से बाहर नहीं जाती है।
- क्या यह अंग्रेजी और संख्याओं के मिश्रण वाले दस्तावेजों का समर्थन करता है?
- हाँ। सभी भाषा सेटिंग्स में बुनियादी लैटिन वर्णमाला, संख्यात्मक अंक और विराम चिह्न डिफ़ॉल्ट रूप से पहचाने जाते हैं।
नोट: यह टूल PP-OCRv5 और PP-OCRv6 डीप लर्निंग मॉडल द्वारा संचालित है, जो जटिल प्रारूपों में भी सटीक टेक्स्ट पहचान सुनिश्चित करता है।