온라인 스캔 PDF OCR 텍스트 인식 및 편집 도구
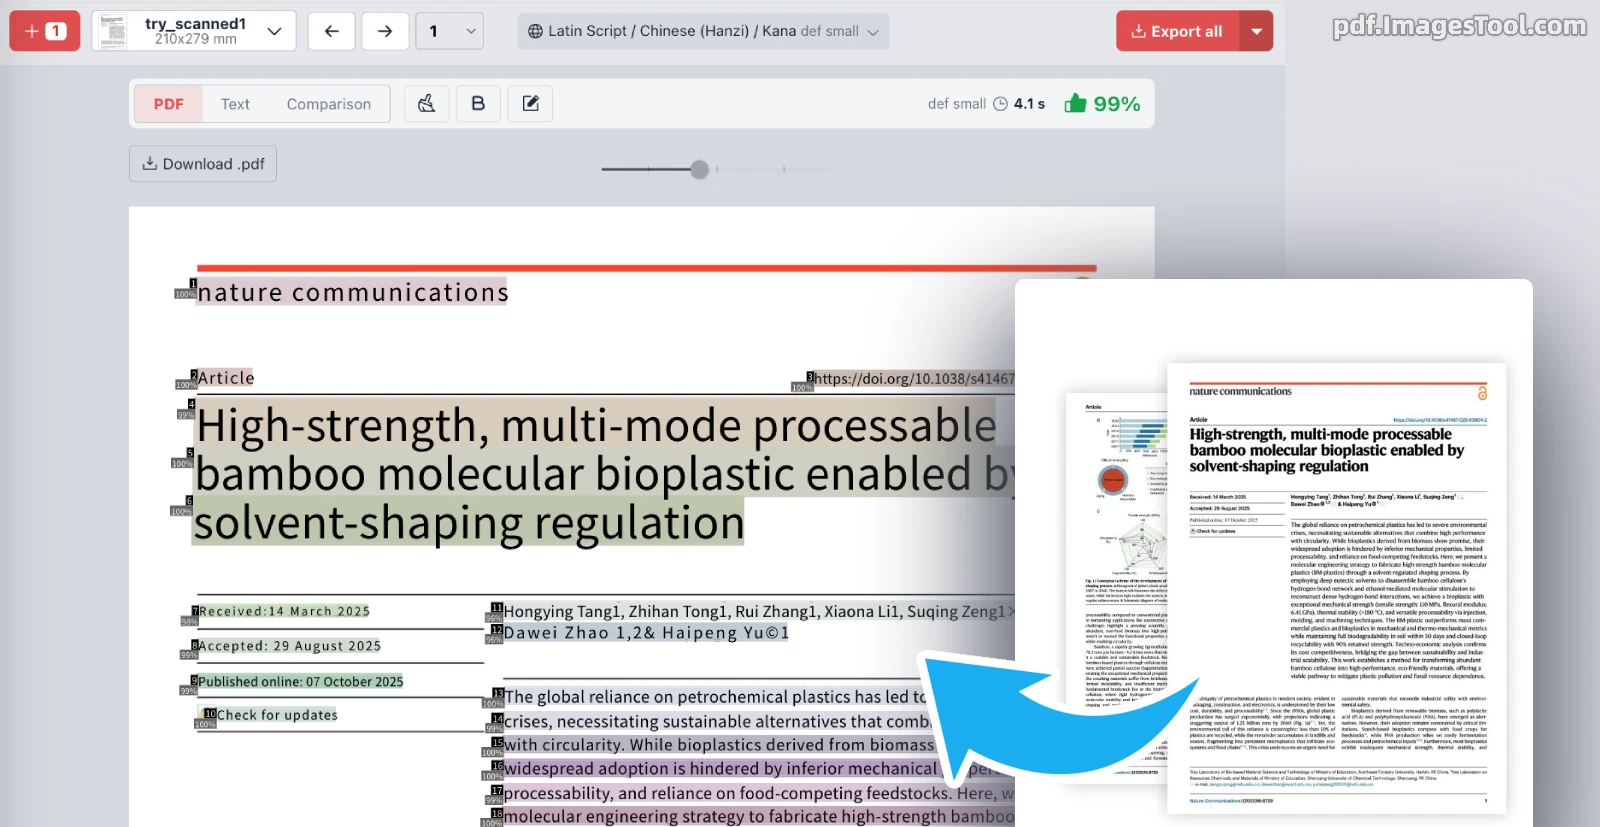
스캔된 PDF 및 이미지형 문서 전용으로 설계된 안전하고 강력한 온라인 PDF OCR 인식 도구입니다. 브라우저 내에서 즉시 텍스트 추출과 레이아웃 복원을 수행하며, 실시간 텍스트 편집 및 교정, 검색 가능한 투명 텍스트 2중 레이어 PDF, TXT 파일 및 원본 비교 이미지 저장을 지원합니다.
이용 방법
- 스캔된 PDF 페이지 또는 이미지 파일(jpg, webp, png)을 업로드합니다.
- 문서의 주 언어 및 인식 정밀도 모드(빠름 / 균형 / 고정밀)를 선택합니다.
- 시스템이 텍스트 영역을 자동으로 분석하고 올바른 다단 읽기 순서를 유지합니다.
- 내장된 편집기에서 결과를 확인하고 필요에 따라 텍스트를 수정, 삭제하거나 굵게 지정합니다.
- 내보내기 버튼을 클릭하여 투명 텍스트 2중 PDF, 순수 TXT 또는 비교 이미지를 다운로드합니다.
핵심 기능 및 장점
- 실시간 온라인 편집 및 교정:OCR 처리 직후 웹 브라우저에서 추출된 텍스트를 즉시 수정, 삭제, 굵은 글씨로 편집할 수 있어 교정 작업 효율이 극대화됩니다.
- 스마트 다단 레이아웃 분석 및 읽기 순서 복원:학술 논문, 정기간행물, 신문 등의 복잡한 다단 구성을 정확하게 파악하여 단이 섞이지 않고 자연스러운 독서 흐름대로 텍스트를 추출합니다.
- 검색 가능한 2중 레이어 PDF 생성:원본 스캔 이미지 위에 보이지 않는 투명 텍스트 레이어를 정렬 결합하여 원본 화질을 그대로 유지하면서 텍스트 복사, 하이라이트 및 전체 검색을 지원합니다.
- 다양한 내보내기 형식:검색 가능한 PDF뿐만 아니라 순수 텍스트(TXT) 및 원본 대조용 비교 이미지(Comparison) 추출을 지원하여 인식 결과를 신속히 점검할 수 있습니다.
- 브라우저 로컬 구동으로 완벽한 프라이버시 보호:모든 문서 분석 및 파일 변환이 사용자의 로컬 브라우저 내에서 직접 수행되어 민감한 파일이 외부로 유출되지 않으며, 다중 페이지 일괄 처리가 가능합니다.
- 유연한 3단계 정밀도 모델 전환:'빠름(Fast)', '균형(Balanced)', '고정밀(High precision)' 3가지 인식 모드를 제공하여 작업 상황에 맞게 속도 또는 정확도를 최적화할 수 있습니다.
폭넓은 다국어 및 문자 인식 지원
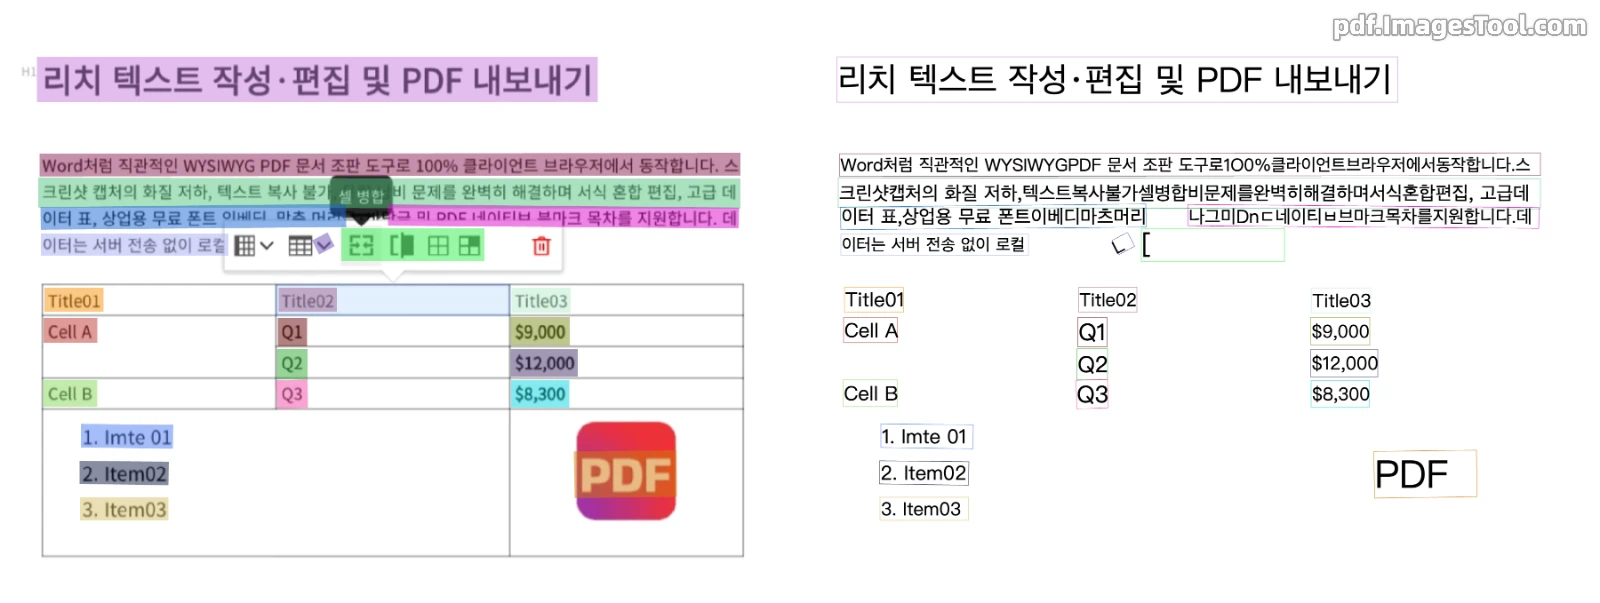
모든 언어 설정에는 알파벳, 아라비아 숫자 및 표준 문장 부호 인식이 기본 포함되어 있어 전 세계 100여 개 주요 언어를 정확하게 판독합니다:
한자, 가나 및 라틴 문자 계열 (50개 이상 언어)
한국어, 简体中文, 繁體中文, 日本語, English, Tiếng Việt, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Azərbaycan dili, Oʻzbekcha, Deutsch, Français, Italiano, Español, Português, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori 등.
키릴 문자 계열 (33개 언어)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
아랍 문자 계열 (8개 언어)
العربية (아랍어), فارسی (페르시아어), ئۇيغۇرچە (위구르어), اردو (우르두어), پښتو (파슈토어), کوردی (쿠르드어), سنڌي (신디어), بلۆچی (발루치어).
데바나가리 문자 계열 (12개 언어)
हिन्दी (힌디어), मराठी (마라티어), नेपाली (네팔어), संस्कृतम् (산스크리트어), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी.
기타 문자 체계
- 한국어 (한글)
- ภาษาไทย (태국어)
- Ελληνικά (그리스어)
- தமிழ் (타밀어)
- తెలుగు (텔루구어)
자주 묻는 질문 (FAQ)
- 투명 텍스트 레이어가 포함된 2중 레이어 PDF란 무엇인가요?
- 스캔된 원본 이미지 위 또는 아래에 완벽하게 정렬된 비가시적(투명) 텍스트를 배치한 PDF입니다. 원본 스캔본의 시각적 형태를 온전히 유지하면서 텍스트 선택, 복사 및 전문 검색이 가능해집니다.
- 기밀 스캔 문서가 외부 클라우드 서버로 업로드되나요?
- 전송되지 않습니다. 본 도구는 브라우저 내부의 로컬 딥러닝 엔진을 통해 독립적으로 추론을 수행하므로, 계약서, 의료 기록, 재무 서류 등 민감한 문서도 외부 유출 위험 없이 안전하게 처리됩니다.
- 영문과 숫자가 섞인 문서도 원활히 인식되나요?
- 네, 완벽히 지원합니다. 모든 언어 선택지에는 영문 알파벳과 숫자, 기본 기호 판독 기능이 기본 내장되어 있어 별도 설정 없이 인식 가능합니다.
안내: 본 서비스의 OCR 엔진은 최신 PP-OCRv5 및 PP-OCRv6 딥러닝 아키텍처를 기반으로 구축되어 복잡한 문서 구조 분석과 탁월한 텍스트 인식률을 보장합니다.