Онлайн-инструмент распознавания текста (OCR) и редактирования сканированных PDF
Высокопроизводительный и безопасный инструмент оптического распознавания текста (OCR) для сканированных PDF и графических документов. Выполняйте извлечение текста и реконструкцию верстки прямо в браузере с возможностью редактирования в реальном времени и экспортом в двухслойный PDF с поиском, файл TXT или визуальное сравнение.
Порядок работы
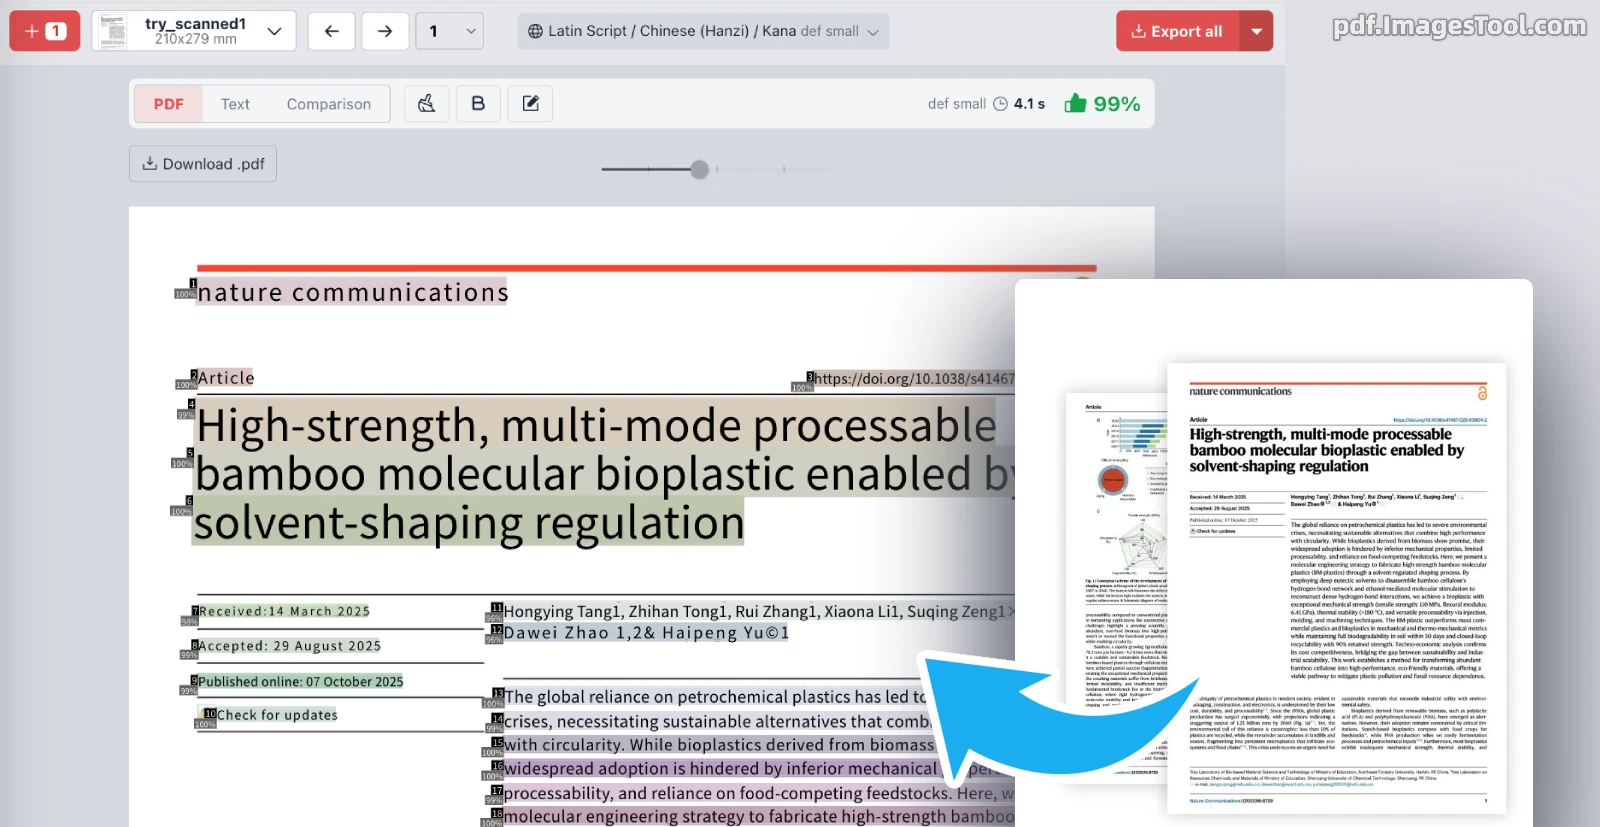
- Загрузите страницы сканированного PDF или изображения (jpg, webp, png).
- Выберите основной язык текста и профиль точности (Быстрый / Сбалансированный / Высокая точность).
- Система автоматически распознает текстовые блоки с сохранением корректного порядка колонок.
- Отредактируйте полученный текст во встроенном редакторе (исправление, удаление, выделение полужирным).
- Нажмите кнопку экспорта, чтобы скачать двухслойный PDF с прозрачным текстом, TXT или изображение для сверки.
Ключевые преимущества
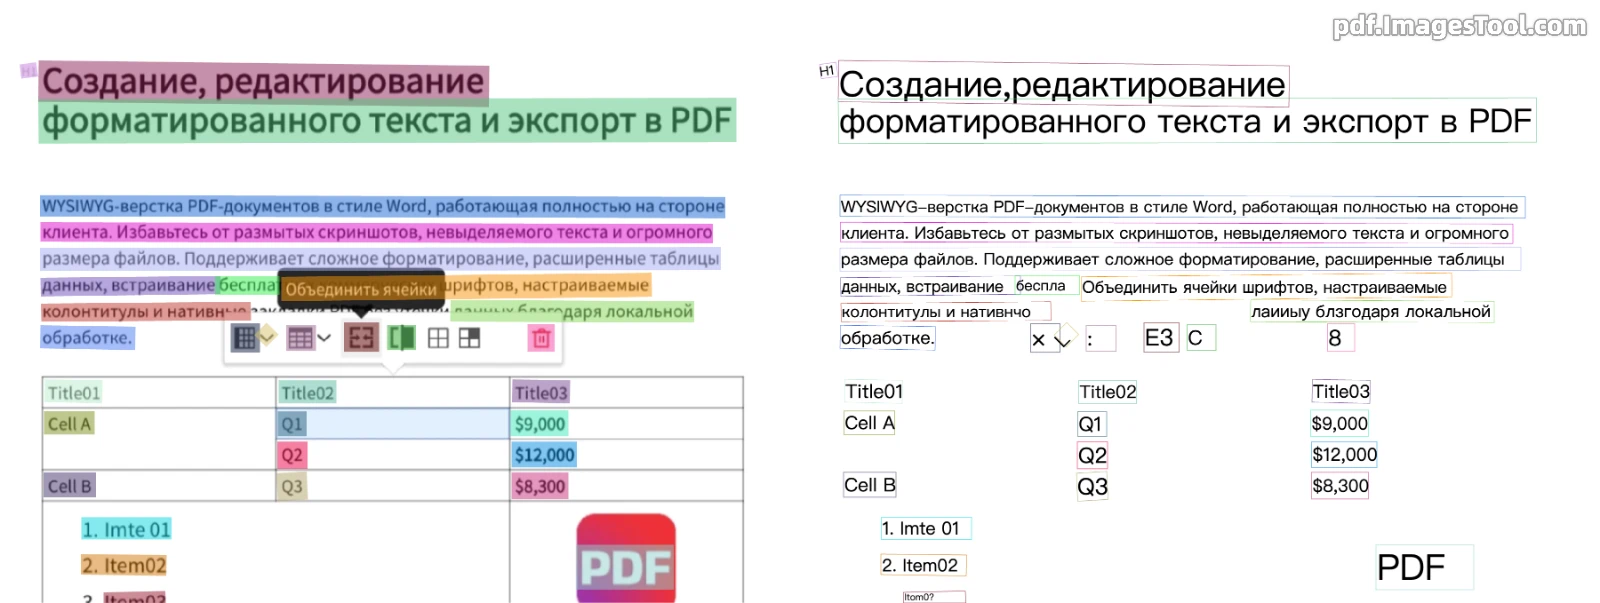
- Редактирование и вычитка онлайн в реальном времени:Вносите правки, форматируйте и удаляйте фрагменты сразу после распознавания непосредственно в браузере в режиме WYSIWYG.
- Интеллектуальный анализ многоколоночной верстки:Точно анализирует макеты научных статей, журналов и газет, извлекая текст в естественном порядке чтения без смешивания колонок.
- Экспорт в двухслойный PDF с текстовым поиском:Создает PDF со слоем прозрачного текста, наложенным на сканированное изображение: 100% сохранение внешнего вида с возможностью выделения, копирования и полнотекстового поиска.
- Гибкие варианты сохранения:Помимо двухслойного PDF доступен экспорт обычного текста (TXT), а также сравнительных изображений (Comparison) для быстрой проверки точности.
- Локальная работа в браузере и конфиденциальность:Все вычисления происходят на вашем устройстве без отправки документов на внешние серверы, что гарантирует безопасность договоров, медицинских и финансовых бумаг.
- Три режима распознавания на выбор:Переключайтесь между режимами 'Быстрый (Fast)', 'Сбалансированный (Balanced)' и 'Высокая точность (High precision)' под любые сценарии.
Широкая поддержка языков и систем письменности
В каждый языковой пакет по умолчанию входит распознавание латинских букв, арабских цифр и основных знаков пунктуации для более чем 100 языков:
Кириллица (33 языка)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
Латиница, иероглифы и кана (более 50 языков)
English, Deutsch, Français, Italiano, Español, Português, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, 简体中文, 繁體中文, 日本語, Tiếng Việt, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Azərbaycan dili, Oʻzbekcha, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori и др.
Арабская вязка (8 языков)
العربية (Арабский), فارسی (Фарси), ئۇيغۇرچە (Уйгурский), اردو (Урду), پښتو (Пушту), کوردی (Курдский), سنڌي (Синдхи), بلۆچی (Белуджский).
Деванагари (12 языков)
हिन्दी (Хинди), मराठी (Маратхи), नेपाली (Непальский), संस्कृतम् (Санскрит), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी.
Другие письменности
- 한국어 (Корейский)
- ภาษาไทย (Тайский)
- Ελληνικά (Греческий)
- தமிழ் (Тамильский)
- తెలుగు (Телугу)
Часто задаваемые вопросы (FAQ)
- Что такое двухслойный PDF с прозрачным текстом?
- Это PDF-файл, в котором поверх или под отсканированным изображением встроен невидимый слой текста с точным позиционированием. Это оставляет визуальную структуру нетронутой, но дает возможность выделять, копировать и находить слова поиском.
- Передаются ли конфиденциальные документы на сервер?
- Нет. Все операции выполняются исключительно локально в вашем браузере. Данные не покидают компьютер пользователя, что гарантирует полную безопасность конфиденциальных сведений.
- Поддерживаются ли тексты со смешанным языком и числами?
- Да. Алгоритм по умолчанию поддерживает чтение латинских букв, цифр и общепринятых знаков препинания во всех языковых режимах.
Примечание: Инструмент базируется на нейросетевых моделях глубокого обучения PP-OCRv5 и PP-OCRv6, гарантируя высочайшую точность сегментации сложных страниц и распознавания текста.