オンラインスキャンPDF OCR文字認識・編集ツール
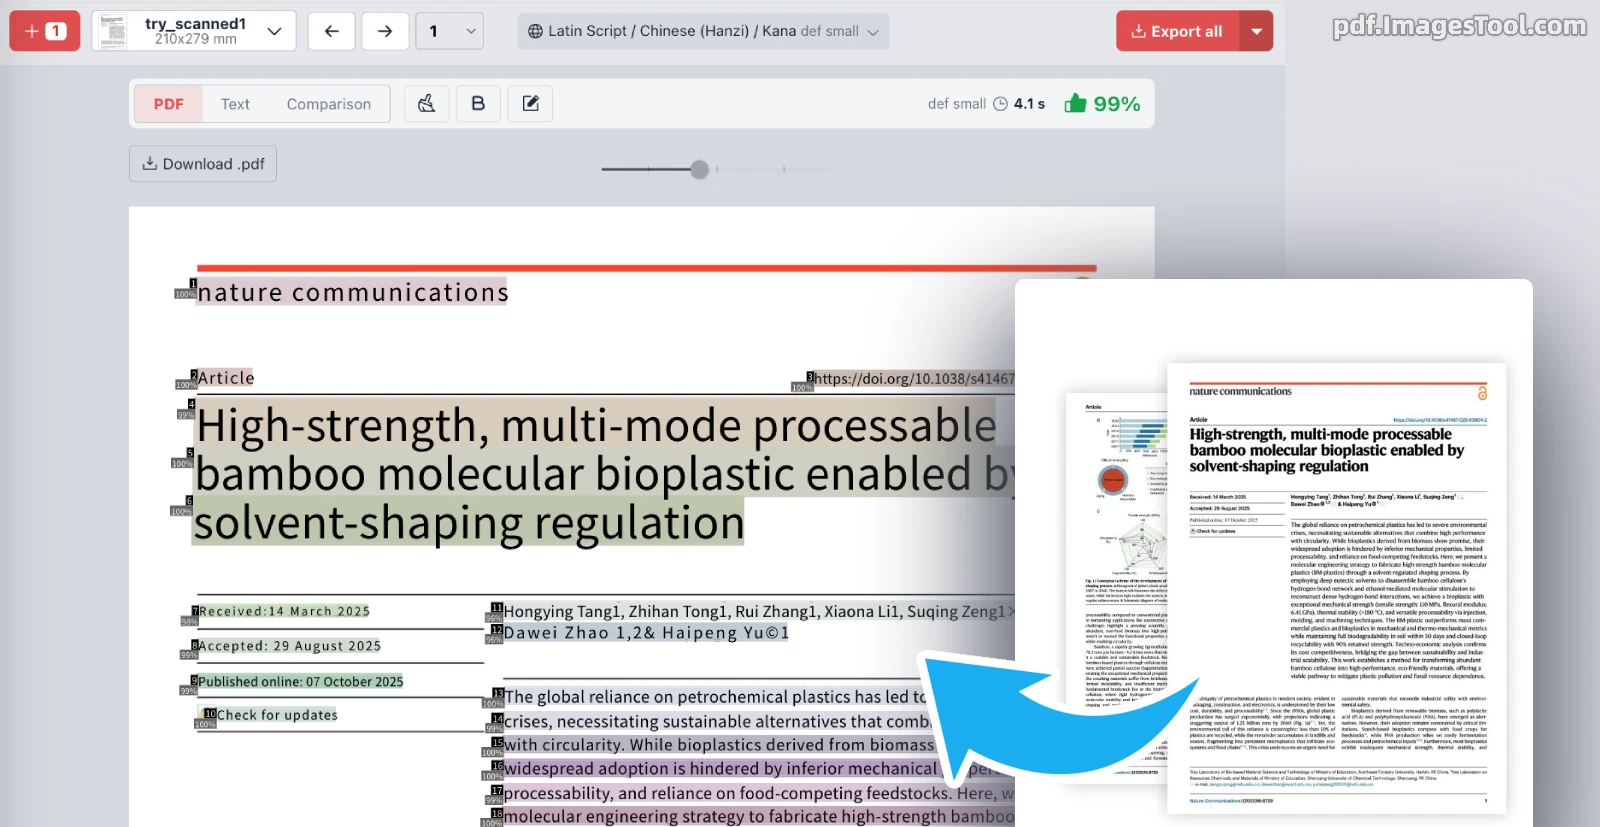
スキャンPDFや画像化された文書に特化した、高精度でセキュアなオンラインOCRツールです。ブラウザ上で文書のテキスト認識とレイアウト復元を直接実行し、リアルタイムでの編集や校正、検索可能な透明テキスト付き2層PDF、TXTファイル、画像比較結果のワンクリック書き出しに対応します。
利用手順
- スキャンPDFのページまたは画像ファイル(jpg、webp、png)をアップロードします。
- 文書の主要言語と認識精度モード(高速 / バランス / 高精度)を選択します。
- システムがテキスト領域を自動検出し、正しい段組み順序を保持します。
- 内蔵エディタで認識結果を確認し、テキストの修正、削除、太字指定を自由に行えます。
- 書き出しボタンをクリックし、透明テキスト付き2層PDF、プレーンTXT、または比較画像をダウンロードします。
主な機能と特長
- リアルタイムなオンライン編集と校正:OCR認識後、ブラウザ上で認識テキストの編集、削除、太字強調が直接行え、作業効率が大幅に向上します。
- 高度な段組み解析と読書順序の復元:学術論文や新聞、雑誌などの複雑な段組みレイアウトを自動分析し、自然な読書フローに従ってテキストを抽出。段をまたぐ誤抽出を防ぎます。
- 検索可能な2層PDF(透明テキスト)書き出し:スキャン画像の直下に透明テキスト層を配置した2層PDFを作成。原本の見た目を完全に保ちつつ、テキストの選択・コピーや全文検索が可能です。
- 多彩なエクスポート形式:2層PDFに加え、プレーンテキスト(TXT)やOCR精度確認用の比較画像(Comparison)の個別出力にも対応しています。
- 完全ブラウザ内処理による堅牢なプライバシー:文書処理は端末のブラウザ上でローカルに実行されるため、機密ファイルが外部サーバーに送信される心配はありません。複数ページ処理にも対応。
- 柔軟な3段階の認識精度切り替え:'高速(Fast)'、'バランス(Balanced)'、'高精度(High precision)'の3つのモードを用意し、速度優先から最高精度の要求まで幅広く応えます。
広範な多言語・複数文字体系サポート
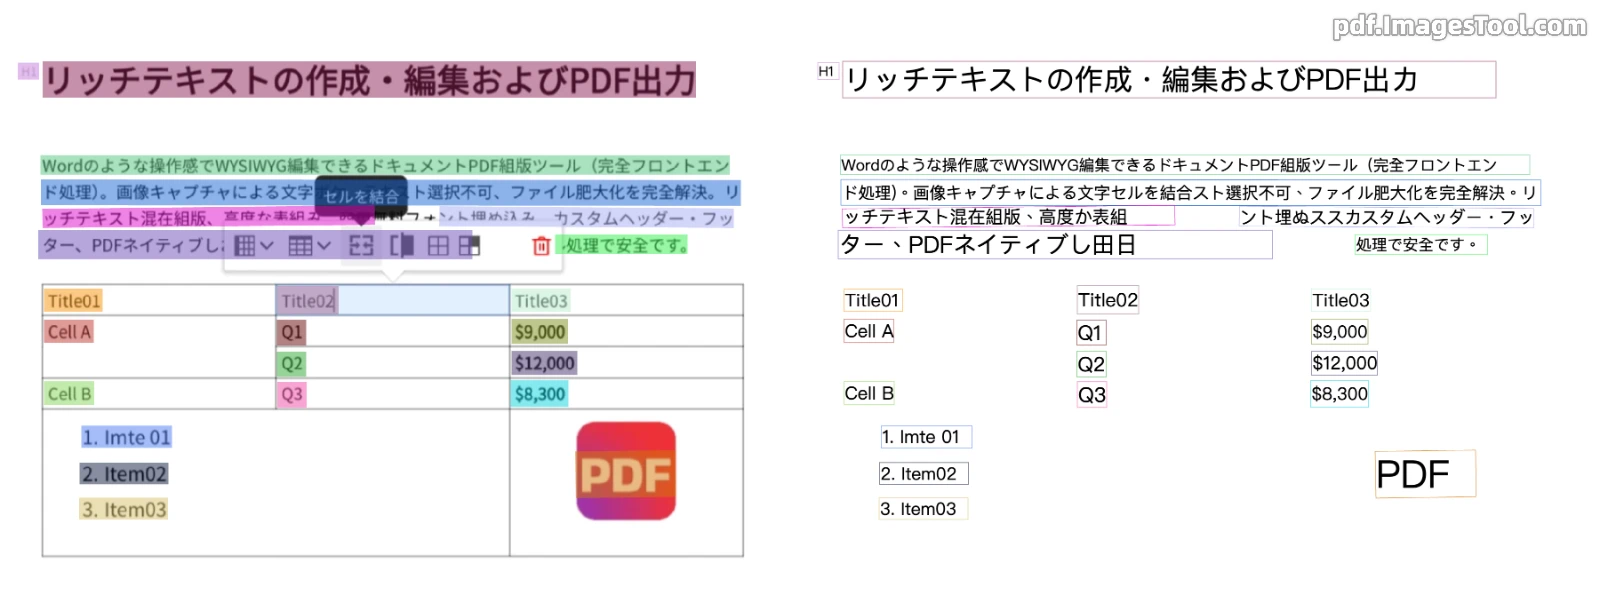
各言語オプションには、英数字および一般的な記号の認識機能が標準で組み込まれており、世界各地の100以上の言語に対応しています:
漢字・仮名およびラテン文字(50以上の言語)
日本語、簡体字中国語、繁体字中国語、English、Tiếng Việt、Bahasa Indonesia、Bahasa Melayu、Tagalog、Türkçe、Azərbaycan dili、Oʻzbekcha、Deutsch、Français、Italiano、Español、Português、Nederlands、Polski、Čeština、Slovenčina、Magyar、Română、Srpski (latinica)、Hrvatski、Bosanski、Slovenščina、Shqip、Svenska、Dansk、Norsk、Suomi、Eesti、Latviešu、Lietuvių、Íslenska、Gaeilge、Cymraeg、Euskara、Català、Galego、Occitan、Rumantsch、Lëtzebuergesch、Malti、Kurdî、Latina、Kiswahili、Afrikaans、Runasimi、Te Reo Māori など。
キリル文字(33言語)
Русский、Беларуская、Українська、Српски (ћирилица)、Български、Монгол хэл、Аҧсшәа、Адыгэбзэ、Адыгэбзэ (Къэбэрдей)、Авар мацӀ、Дарган мез、Гӏалгӏай мотт、Нохчийн мотт、Лакку маз、Лезги чIал、Табасаран чIал、Қазақша、Кыргызча、Тоҷикӣ、Македонски、Татарча、Чӑвашла、Башҡортса、Марий йылме、Мокшень / Эрзянь кяль、Удмурт кыл、Коми кыв、Ирон æвзаг、Буряад хэлэн、Хальмг келн、Тыва дыл、Саха тыла、Qaraqalpaqsha (Кирилл)。
アラビア文字(8言語)
العربية(アラビア語)、فارسی(ペルシャ語)、ئۇيغۇرچە(ウイグル語)、اردو(ウルドゥー語)、پښتو(パシュトー語)、کوردی(クルド語)、سنڌي(シンド語)、بلۆچی(バローチー語)。
デーヴァナーガリー文字(12言語)
हिन्दी(ヒンディー語)、मराठी(マラーティー語)、नेपाली(ネパール語)、संस्कृतम्(サンスクリット語)、मैथिली、भोजपुरी、मगही、सादरी、नेपाल भाषा、कोंकणी、हरियाणवी、बिहारी。
その他の文字体系
- 한국어(韓国語/朝鮮語)
- ภาษาไทย(タイ語)
- Ελληνικά(ギリシャ語)
- தமிழ்(タミル語)
- తెలుగు(テルグ語)
よくある質問 (FAQ)
- 透明テキスト付き2層PDFとは何ですか?
- 2層PDFとは、スキャン画像の下層または上層に正確に位置合わせされた透明なテキストを重ね合わせたPDFです。原本のビジュアルを完全に保持したまま、テキストのコピーや検索が可能になります。
- 機密文書がクラウドサーバーにアップロードされることはありますか?
- いいえ、アップロードされません。すべてのOCR推論およびファイル生成はブラウザ内のローカルエンジンで完結するため、契約書や医療記録、会計書類などの機密文書も安心して処理できます。
- 英数字が混在した文書も認識できますか?
- はい、対応しています。すべての言語設定において、英文字や数字、標準的な記号の認識が標準で有効になっています。
注:本ツールのOCRエンジンは PP-OCRv5 および PP-OCRv6 ディープラーニングモデルを基盤に構築されており、複雑なレイアウト解析と高い文字認識率を実現しています。