Công cụ OCR nhận dạng và chỉnh sửa văn bản PDF scan trực tuyến
Công cụ OCR PDF trực tuyến an toàn và hiệu quả, được thiết kế chuyên biệt cho tệp PDF dạng quét và tài liệu hình ảnh. Nhận dạng ký tự và khôi phục định dạng ngay trong trình duyệt, hỗ trợ hiệu đính văn bản trực tiếp và xuất tệp PDF hai lớp có thể tìm kiếm, tệp TXT cùng hình ảnh đối chiếu chuẩn xác.
Quy trình sử dụng
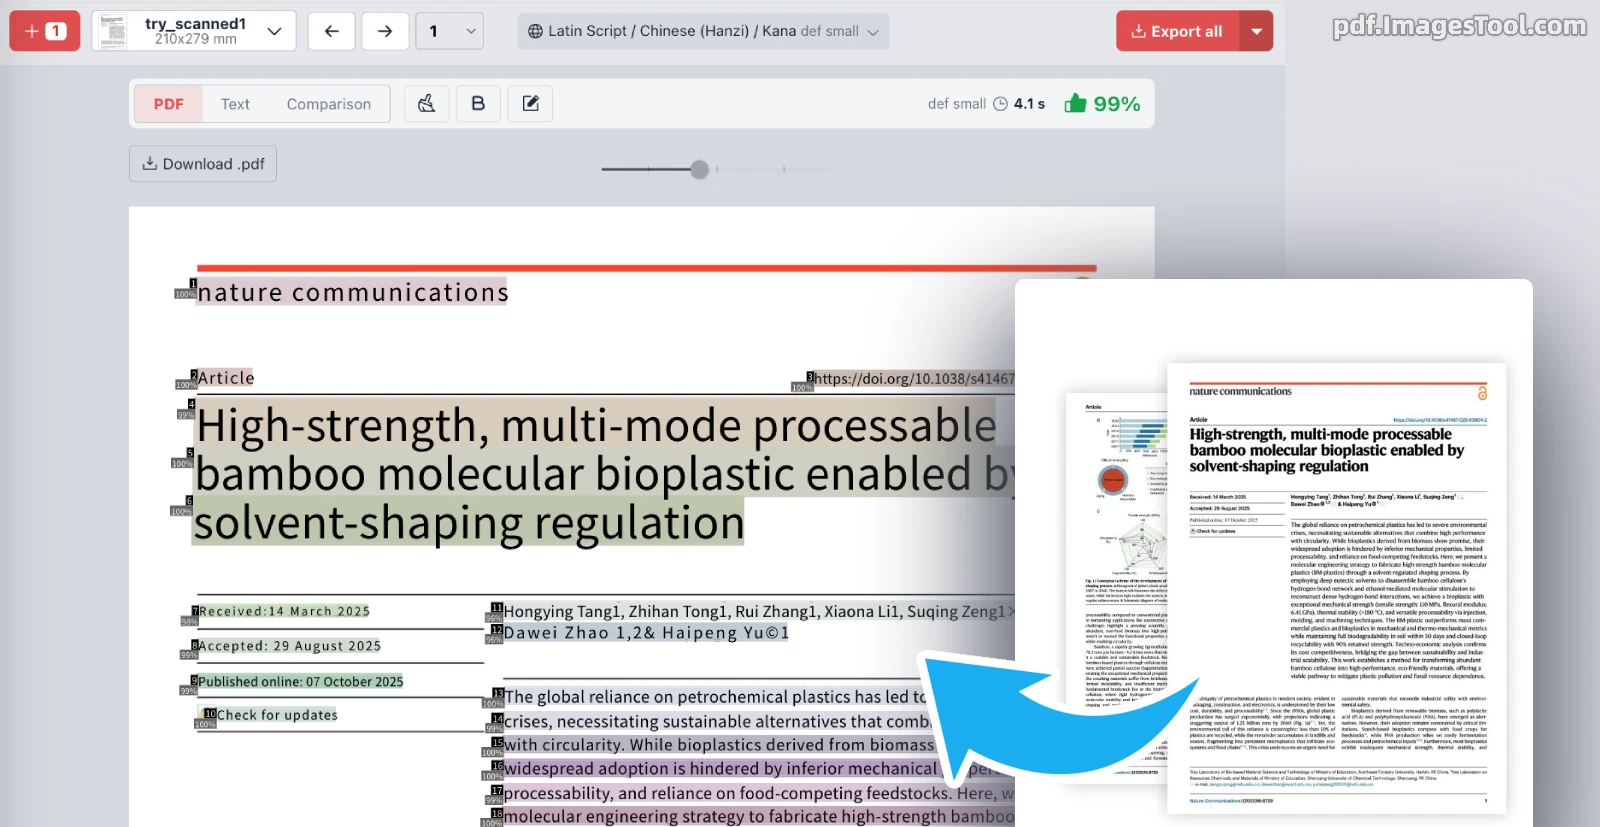
- Tải lên trang PDF scan hoặc tệp hình ảnh (jpg, webp, png).
- Chọn ngôn ngữ chính của tài liệu và chế độ chính xác (Nhanh / Cân bằng / Độ chính xác cao).
- Hệ thống tự động phân vùng văn bản và duy trì đúng thứ tự đọc theo cột.
- Kiểm tra kết quả trong trình chỉnh sửa tích hợp để sửa đổi, xóa hoặc in đậm nội dung.
- Nhấp vào nút Xuất để tải xuống PDF hai lớp chứa lớp văn bản trong suốt, tệp TXT hoặc ảnh so sánh.
Tính năng nổi bật và ưu điểm
- Chỉnh sửa và hiệu đính trực tiếp:Sau khi OCR hoàn tất, bạn có thể chỉnh sửa, xóa và bôi đậm văn bản trực tiếp ngay trên trang web mà không cần cài thêm phần mềm.
- Tái tạo bố cục nhiều cột thông minh:Phân tích chính xác cấu trúc văn bản nhiều cột trong các bài báo khoa học, tạp chí, trích xuất chuẩn theo thứ tự đọc tự nhiên của người dùng.
- Xuất PDF hai lớp có thể tìm kiếm văn bản:Tạo tệp PDF phủ một lớp chữ trong suốt khớp hoàn hảo với bản scan gốc, giữ nguyên 100% hình ảnh ban đầu đồng thời cho phép bôi đen, sao chép và tìm kiếm từ khóa.
- Định dạng xuất đa dạng:Ngoài PDF hai lớp, bạn có thể tải về tệp văn bản thuần (TXT) hoặc hình ảnh so sánh (Comparison) để kiểm tra độ chuẩn xác của kết quả.
- Xử lý cục bộ bảo mật tuyệt đối:Toàn bộ tiến trình chạy trực tiếp trên trình duyệt thiết bị cá nhân, không gửi tài liệu mật lên máy chủ bên ngoài, hỗ trợ nhận dạng nhiều trang tiện lợi.
- Ba cấp độ chính xác linh hoạt:Dễ dàng tùy chọn giữa các chế độ 'Nhanh (Fast)', 'Cân bằng (Balanced)' và 'Độ chính xác cao (High precision)' phù hợp với nhu cầu thời gian hoặc chất lượng nhận diện.
Hỗ trợ đa ngôn ngữ và nhiều hệ chữ viết phong phú
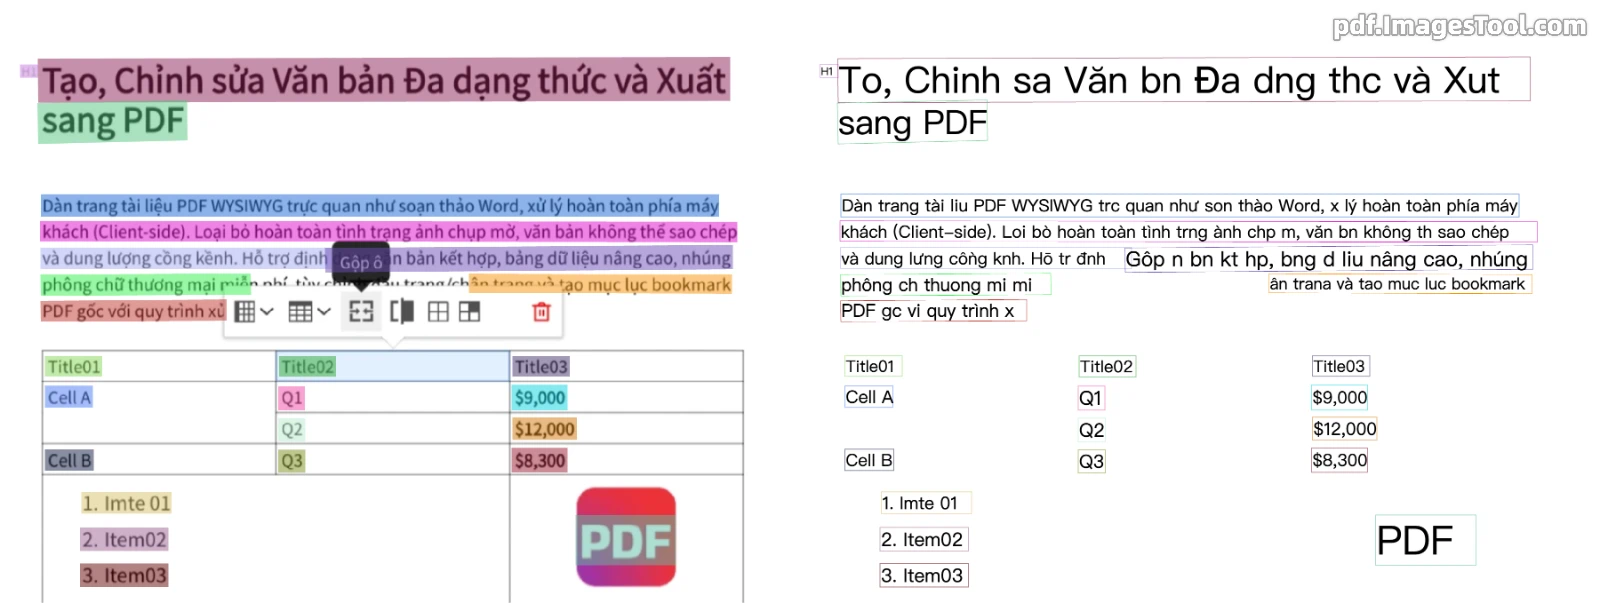
Mọi tùy chọn ngôn ngữ đều tích hợp sẵn khả năng nhận dạng chữ cái Latinh, chữ số và các dấu câu thông dụng cho hàng trăm ngôn ngữ:
Chữ Latinh, Hán tự và Kana (hơn 50 ngôn ngữ)
Tiếng Việt, English, 简体中文, 繁體中文, 日本語, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Azərbaycan dili, Oʻzbekcha, Deutsch, Français, Italiano, Español, Português, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori, v.v.
Hệ chữ Cyrillic (33 ngôn ngữ)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
Hệ chữ Ả Rập (8 ngôn ngữ)
العربية (Tiếng Ả Rập), فارسی (Tiếng Ba Tư), ئۇيغۇرچە (Tiếng Duy Ngô Nhĩ), اردو (Tiếng Urdu), پښتو (Tiếng Pashto), کوردی (Tiếng Kurd), سنڌي (Tiếng Sindhi), بلۆچی (Tiếng Balochi).
Hệ chữ Devanagari (12 ngôn ngữ)
हिन्दी (Tiếng Hindi), मराठी (Tiếng Marathi), नेपाली (Tiếng Nepal), संस्कृतम् (Tiếng Phạn), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी.
Các hệ chữ khác
- 한국어 (Tiếng Hàn Quốc)
- ภาษาไทย (Tiếng Thái)
- Ελληνικά (Tiếng Hy Lạp)
- தமிழ் (Tiếng Tamil)
- తెలుగు (Tiếng Telugu)
Câu hỏi thường gặp (FAQ)
- PDF hai lớp có lớp văn bản trong suốt là gì?
- Đây là định dạng tệp PDF chứa một lớp chữ vô hình được căn chỉnh khớp hoàn toàn lên trên hoặc dưới ảnh scan gốc. Nhờ đó, văn bản vẫn giữ nguyên vẹn hình thức trực quan ban đầu nhưng cho phép chọn chữ, sao chép và tìm kiếm toàn văn.
- Tài liệu bảo mật của tôi có bị tải lên máy chủ không?
- Hoàn toàn không. Công cụ xử lý trực tiếp bên trong trình duyệt máy tính của bạn thông qua mô hình cục bộ, đảm bảo an toàn tuyệt đối cho hợp đồng, chứng từ tài chính và hồ sơ bệnh án.
- Công cụ có nhận diện được văn bản chứa chữ xen lẫn số không?
- Có. Nhận diện chữ cái Latinh, ký tự số và dấu câu thông thường được kích hoạt mặc định ở mọi chế độ ngôn ngữ.
Ghi chú: Động cơ OCR dựa trên các mô hình học sâu PP-OCRv5 và PP-OCRv6, đem lại khả năng xử lý bố cục phức tạp và độ chuẩn xác vượt trội.