Online OCR-Texterkennung und Editor für gescannte PDFs
Leistungsstarkes und sicheres Online-PDF-OCR-Tool für gescannte Dokumente und Bilddateien. Führen Sie Texterkennung und Layoutwiederherstellung direkt im Browser aus – inklusive Echtzeit-Textbearbeitung, Korrekturlesung und Sofortexport als durchsuchbares Sandwich-PDF mit unsichtbarer Textebene, TXT-Datei und visueller Vergleichsansicht.
Anleitung / Ablauf
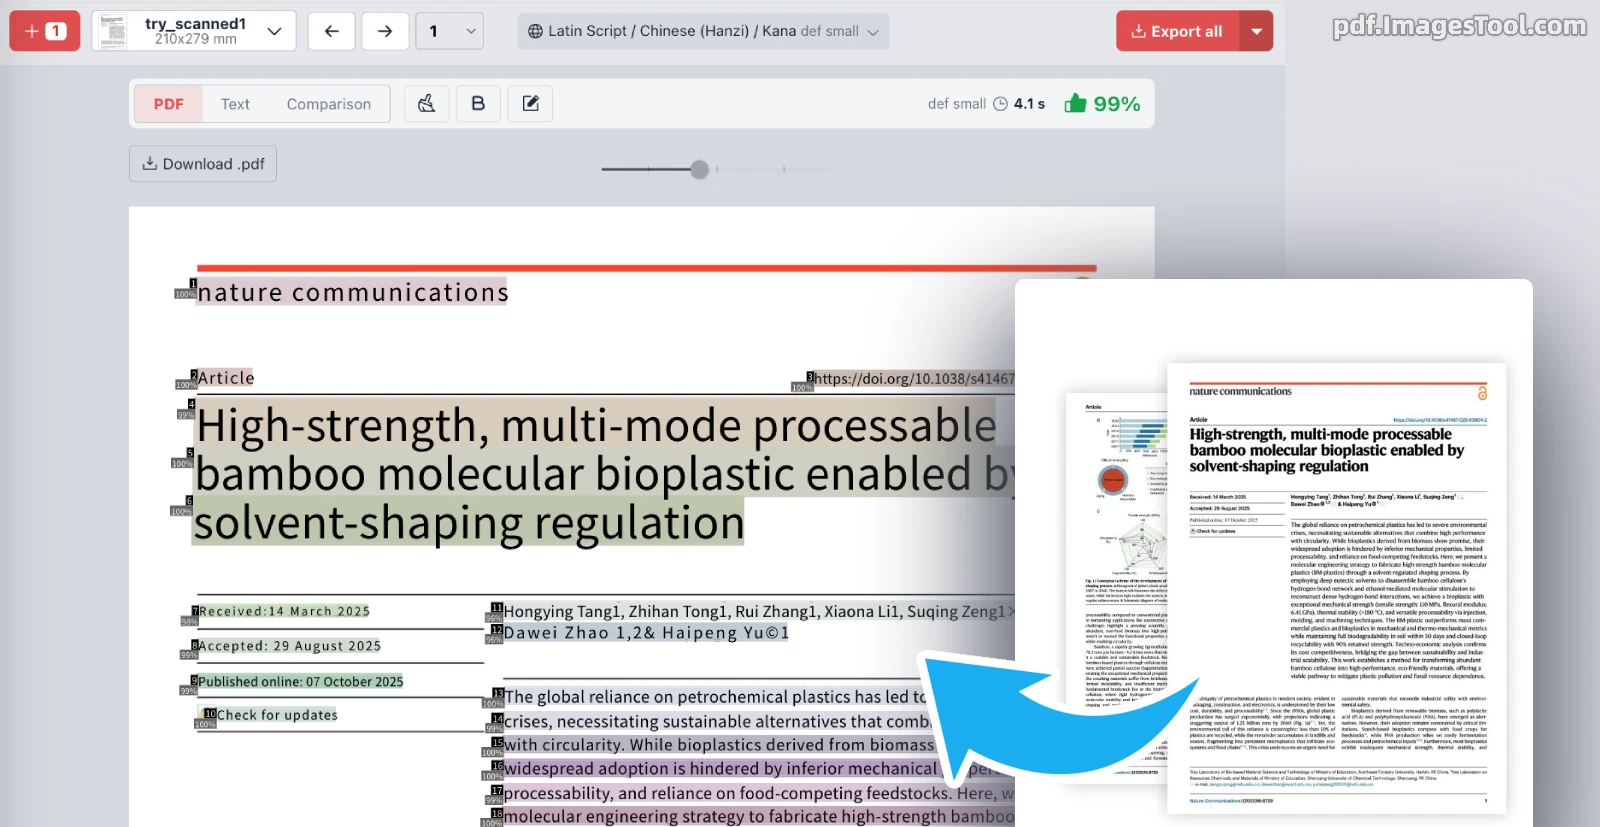
- Gescannte PDF-Seiten oder Bilddateien hochladen (jpg, webp, png).
- Hauptsprache des Dokuments und Genauigkeitsmodus (Schnell / Ausgewogen / Hohe Präzision) festlegen.
- Das System erkennt Textblöcke automatisch und behält die korrekte Spaltenreihenfolge bei.
- Erkannte Texte im integrierten Editor prüfen, anpassen, löschen oder hervorheben.
- Auf Exportieren klicken und durchsuchbare 2-Ebenen-PDFs, reine TXT-Dateien oder Vergleichsbilder herunterladen.
Hauptfunktionen und Vorteile
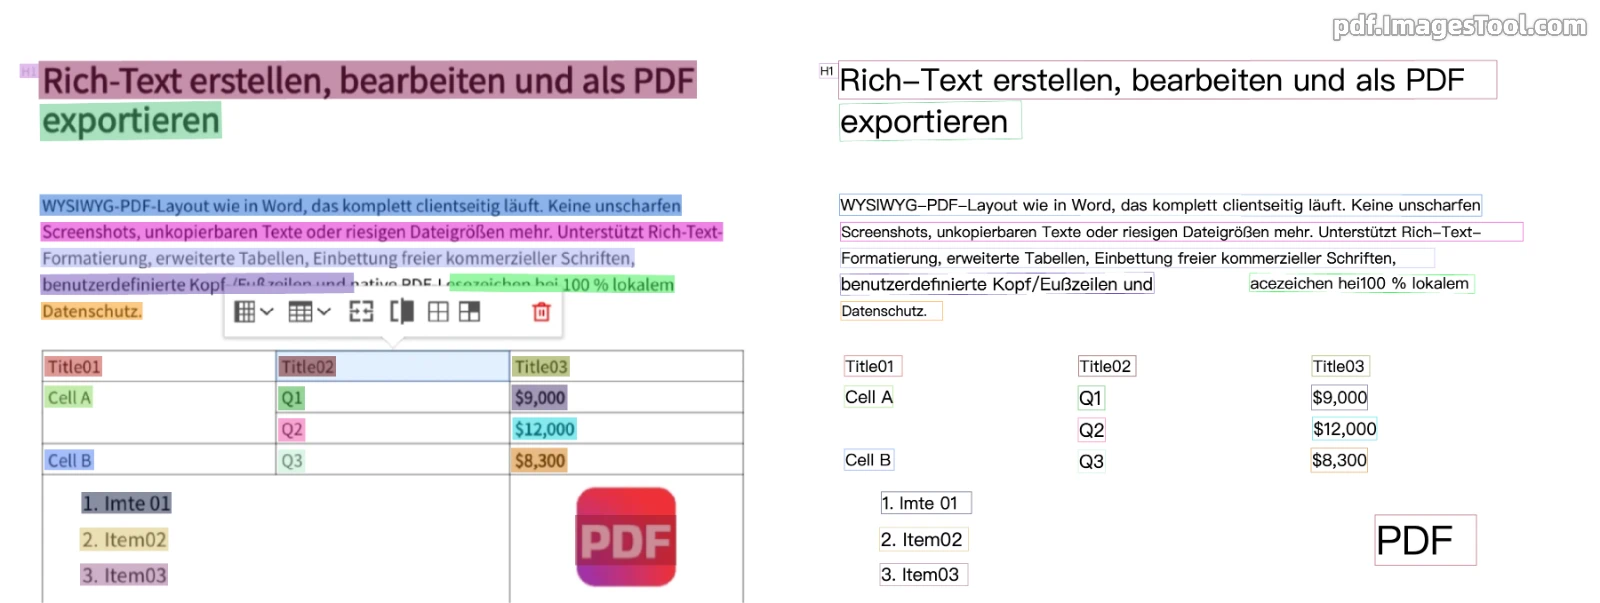
- Sofortige Online-Korrektur:Nach der OCR-Erkennung können Texte direkt im Browser modifiziert, formatiert und bereinigt werden – WYSIWYG für höchste Effizienz.
- Intelligente Mehrspalten-Layoutanalyse:Extrahiert Texte aus wissenschaftlichen Publikationen, Magazinen und Zeitungen präzise entlang des natürlichen Leseflusses, ohne dass Textblöcke spaltenübergreifend vermischt werden.
- Durchsuchbares zweilagiges PDF exportieren:Erstellt ein Dokument mit deckungsgleicher, transparenter Textebene über dem Originalscan – 100 % Layouttreue bei voller Durchsuch- und Kopierbarkeit.
- Vielfältige Exportformate:Exportieren Sie neben durchsuchbaren PDFs auch unformatierte Textdateien (TXT) oder grafische Gegenüberstellungen (Comparison) zur Qualitätskontrolle.
- Reine Browserausführung für maximalen Datenschutz:Die Dokumentenverarbeitung findet lokal im Browser statt. Vertrauliche Unterlagen verlassen Ihr Endgerät zu keinem Zeitpunkt.
- Drei flexible Präzisionsstufen:Wählen Sie zwischen 'Schnell (Fast)', 'Ausgewogen (Balanced)' und 'Hohe Präzision (High precision)', passend zu Ihren Anforderungen an Rechenzeit und Erkennungsgüte.
Umfassende Unterstützung weltweiter Sprachen und Schriften
Jedes Sprachprofil unterstützt standardmäßig lateinische Schriftzeichen, Ziffern und gängige Satzzeichen und deckt über hundert Sprachen ab:
Lateinische Schrift, Han-Zeichen und Kana (50+ Sprachen)
Deutsch, English, Français, Italiano, Español, Português, Nederlands, Polski, Čeština, Slovenčina, Magyar, Română, 简体中文, 繁體中文, 日本語, Tiếng Việt, Bahasa Indonesia, Bahasa Melayu, Tagalog, Türkçe, Azərbaycan dili, Oʻzbekcha, Srpski (latinica), Hrvatski, Bosanski, Slovenščina, Shqip, Svenska, Dansk, Norsk, Suomi, Eesti, Latviešu, Lietuvių, Íslenska, Gaeilge, Cymraeg, Euskara, Català, Galego, Occitan, Rumantsch, Lëtzebuergesch, Malti, Kurdî, Latina, Kiswahili, Afrikaans, Runasimi, Te Reo Māori usw.
Kyrillische Schriften (33 Sprachen)
Русский, Беларуская, Українська, Српски (ћирилица), Български, Монгол хэл, Аҧсшәа, Адыгэбзэ, Адыгэбзэ (Къэбэрдей), Авар мацӀ, Дарган мез, Гӏалгӏай мотт, Нохчийн мотт, Лакку маз, Лезги чIал, Табасаран чIал, Қазақша, Кыргызча, Тоҷикӣ, Македонски, Татарча, Чӑвашла, Башҡортса, Марий йылме, Мокшень / Эрзянь кяль, Удмурт кыл, Коми кыв, Ирон æвзаг, Буряад хэлэн, Хальмг келн, Тыва дыл, Саха тыла, Qaraqalpaqsha (Кирилл).
Arabische Schriften (8 Sprachen)
العربية (Arabisch), فارسی (Persisch), ئۇيغۇرچە (Uigurisch), اردو (Urdu), پښتو (Paschtu), کوردی (Kurdisch), سنڌي (Sindhi), بلۆچی (Belutschi).
Devanagari (12 Sprachen)
हिन्दी (Hindi), मराठी (Marathi), नेपाली (Nepali), संस्कृतम् (Sanskrit), मैथिली, भोजपुरी, मगही, सादरी, नेपाल भाषा, कोंकणी, हरियाणवी, बिहारी.
Weitere Schriftsysteme
- 한국어 (Koreanisch)
- ภาษาไทย (Thailändisch)
- Ελληνικά (Griechisch)
- தமிழ் (Tamil)
- తెలుగు (Telugu)
Häufig gestellte Fragen (FAQ)
- Was zeichnet ein zweilagiges PDF mit transparenter Textebene aus?
- Es kombiniert das ursprüngliche Scanbild mit einer exakt darüberliegenden unsichtbaren Textebene. Das visuelle Erscheinungsbild bleibt originalgetreu erhalten, während Textpassagen markierbar, kopierbar und durchsuchbar werden.
- Werden meine vertraulichen Dokumente auf externe Server übertragen?
- Nein. Die Berechnung erfolgt vollständig lokal über die Browser-Engine. Keine Daten werden extern gespeichert oder hochgeladen – ideal für Verträge, Rechnungen und sensible Patientendaten.
- Werden gemischtsprachige Texte mit Zahlen fehlerfrei erkannt?
- Ja. Grundlegende lateinische Buchstaben, Ziffern und Sonderzeichen werden in jedem Sprachmodus standardmäßig mitverarbeitet.
Hinweis: Unsere OCR-Architektur basiert auf modernen PP-OCRv5- und PP-OCRv6-Deep-Learning-Modellen für höchste Erkennungsgenauigkeit auch bei anspruchsvollen Layouts.